بسیاری از سیستم های نرم افزاری شامل پردازش حجم زیادی از داده های مشتری هر روز است. دسترسی به داده های مشتری نیاز به پردازش و مسئولیت دقیق دارد. حفظ یکپارچگی داده ها بسیار مهم است ، به خصوص در فضاهای بسیار تنظیم شده که برای اطمینان از بالاترین استاندارد خروجی استاندارد ، داده های دقیق لازم است. علاوه بر این ، از آنجا که هر راه حلی که توسط داده ها مدیریت می شود به همان اندازه داده های مبتنی بر داده ها دقیق است ، داده های تمیز برای تصمیم گیری های تجاری با اطلاعات خوب مهم هستند.
این راهنما غوطه ور است که چگونه می توانیم داده های خام را ضد عفونی کنیم تا در سازمان های خودمان سازگار ، تمیز و دقیق باقی بماند.
خط لوله
برای اینکه یک معمار به خط لوله اصلاح که داده های ورودی و بدون ساختار را پردازش می کند ، می توانیم مرحله به مرحله روند را قطع کنیم. ما می خواهیم این داده ها را به تدریج تمیز کنیم تا از ساده ترین (و ارزان تر برای استفاده) برای این مجموعه استفاده شود. این تضمین می کند که ما در مراحل پایانی اعتبار داده ، استفاده از ابزارهای شخص ثالث را در صورت نیاز به آنها بهینه می کنیم.
ما به هر مرحله به صورت جداگانه در زیر نگاه می کنیم.
مثال: دستور العمل های داروسازی
تصور کنید شما یک تکنسین داروسازی هستید که مسئول اجرای سفارشات داروهای دو کلینیک مختلف هستید. دو کلینیک که شما با آن شریک هستید از سیستم مدیریت نسخه خود استفاده می کنید و هرکدام CSV منحصر به فرد را از داده های بیمار برای شما ارسال می کنند.
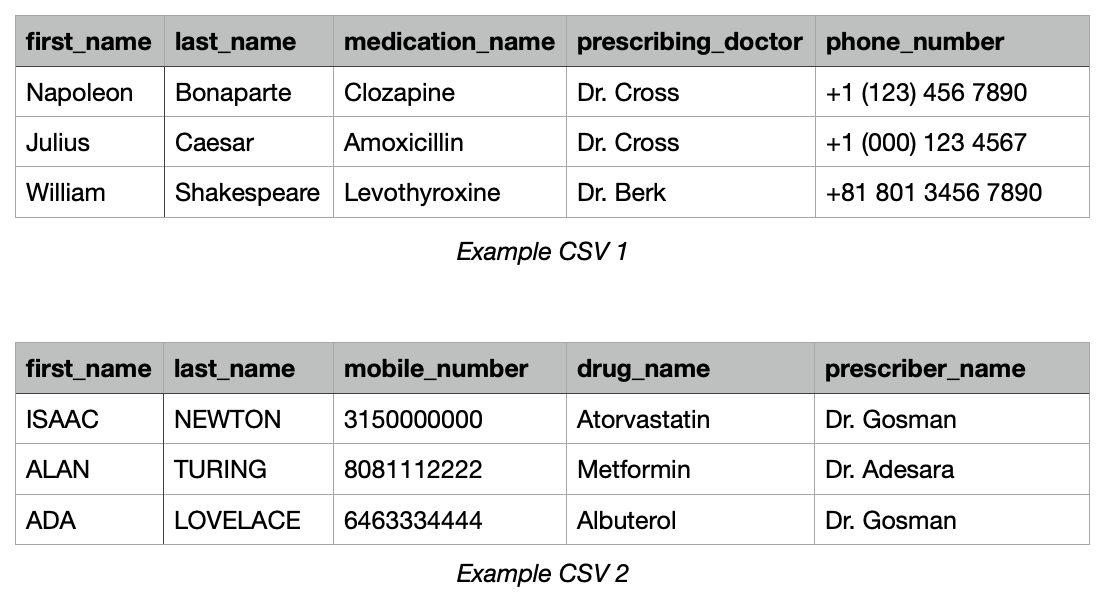
ما می توانیم تفاوتهای واضحی بین این منابع داده مشاهده کنیم. مسکن ، فاصله ، قالب های شماره تلفن ، کنوانسیون های نامگذاری پزشک و نام مواد مخدر.
مرحله 1: داده های اولیه و بدون فیلتر را جمع آوری کنید
غالباً ، مانند مراقبت های بهداشتی ، ابتدا داده ها از طریق “EHR” یا یک سیستم ضبط سلامت الکترونیکی وارد سیستم شخص می شوند. نمونه هایی از داده های خام شامل یادداشت برای فرم رایگان ، سیستم داخلی بیمارستان و ارتباطات سازمانی داخلی بین کلینیک و داروخانه است. سازمان ها و اشخاص مختلف استانداردهای مختلفی از نحوه ورود داده هایی که فضای زیادی را برای ابهام باقی می گذارد.
به عنوان مثال ، یک پزشک ممکن است شماره تلفن های بین المللی را برای بیماران بپذیرد ، در حالی که ممکن است دیگری نباشد – این سؤال که شماره تلفن های بین المللی اغلب بیش از ده رقم مشخصه شماره تلفن های ایالات متحده است.
یک کاری که ما در اینجا می توانیم انجام دهیم این است که تمام CSV های مناسب (اگر با داده های وارد شده به صفحه گسترده انسانی کار می کنید) را به یک پایگاه داده مگا ، مانند PostgreSQL ، یک پایگاه داده رابطه ای بکشید. سپس یک جدول به نام ایجاد کنید patient_raw_input. ، به عنوان مثال سپس می توانیم این سوابق را تجزیه و تحلیل کنیم و منطق اضافی بهداشت را برای این داده ها اعمال کنیم.
مرحله 2: داده ها را عادی کنید
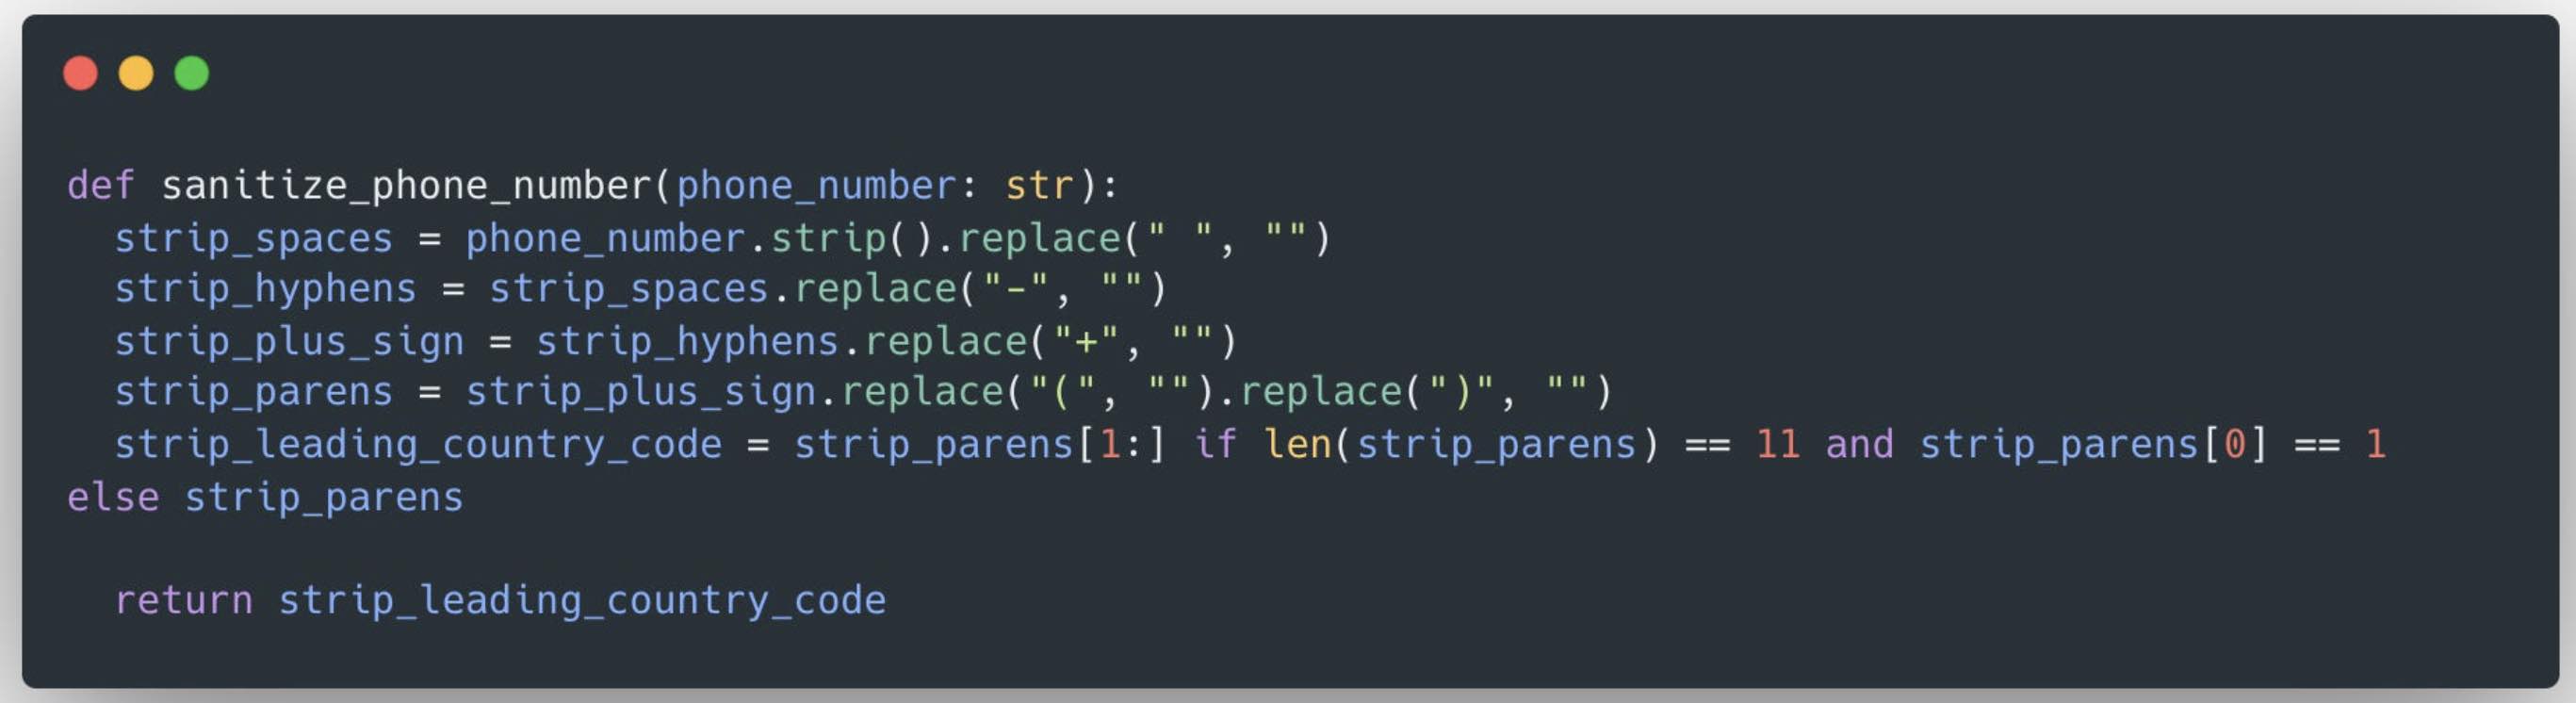
با عادی سازی ، منظور ما اساسی ترین تحولات است که می توانیم در برخی از اطلاعات ایجاد کنیم تا آن را به یک قالب استاندارد وارد کنیم: حذف خط ها ، بارگیری عنوان و از بین بردن فضای بیرونی سفید. این تغییرات اغلب با استفاده از روشهای ساخته شده مانند پایتون امکان پذیر است strip(). ، upper(). ، lower()وت replace()حرف
به عنوان مثال ما:
- فضای سفید چلپ چلوپ از همه سوابق
- عنوان همه نام ها
- خطوط ، براکت ها ، به علاوه علائم و سایر مقادیر غیر عادی را از شماره تلفن حذف کنید
- مورد فوق تمام نام داروها
نتیجه چیزی شبیه به این به نظر می رسد:
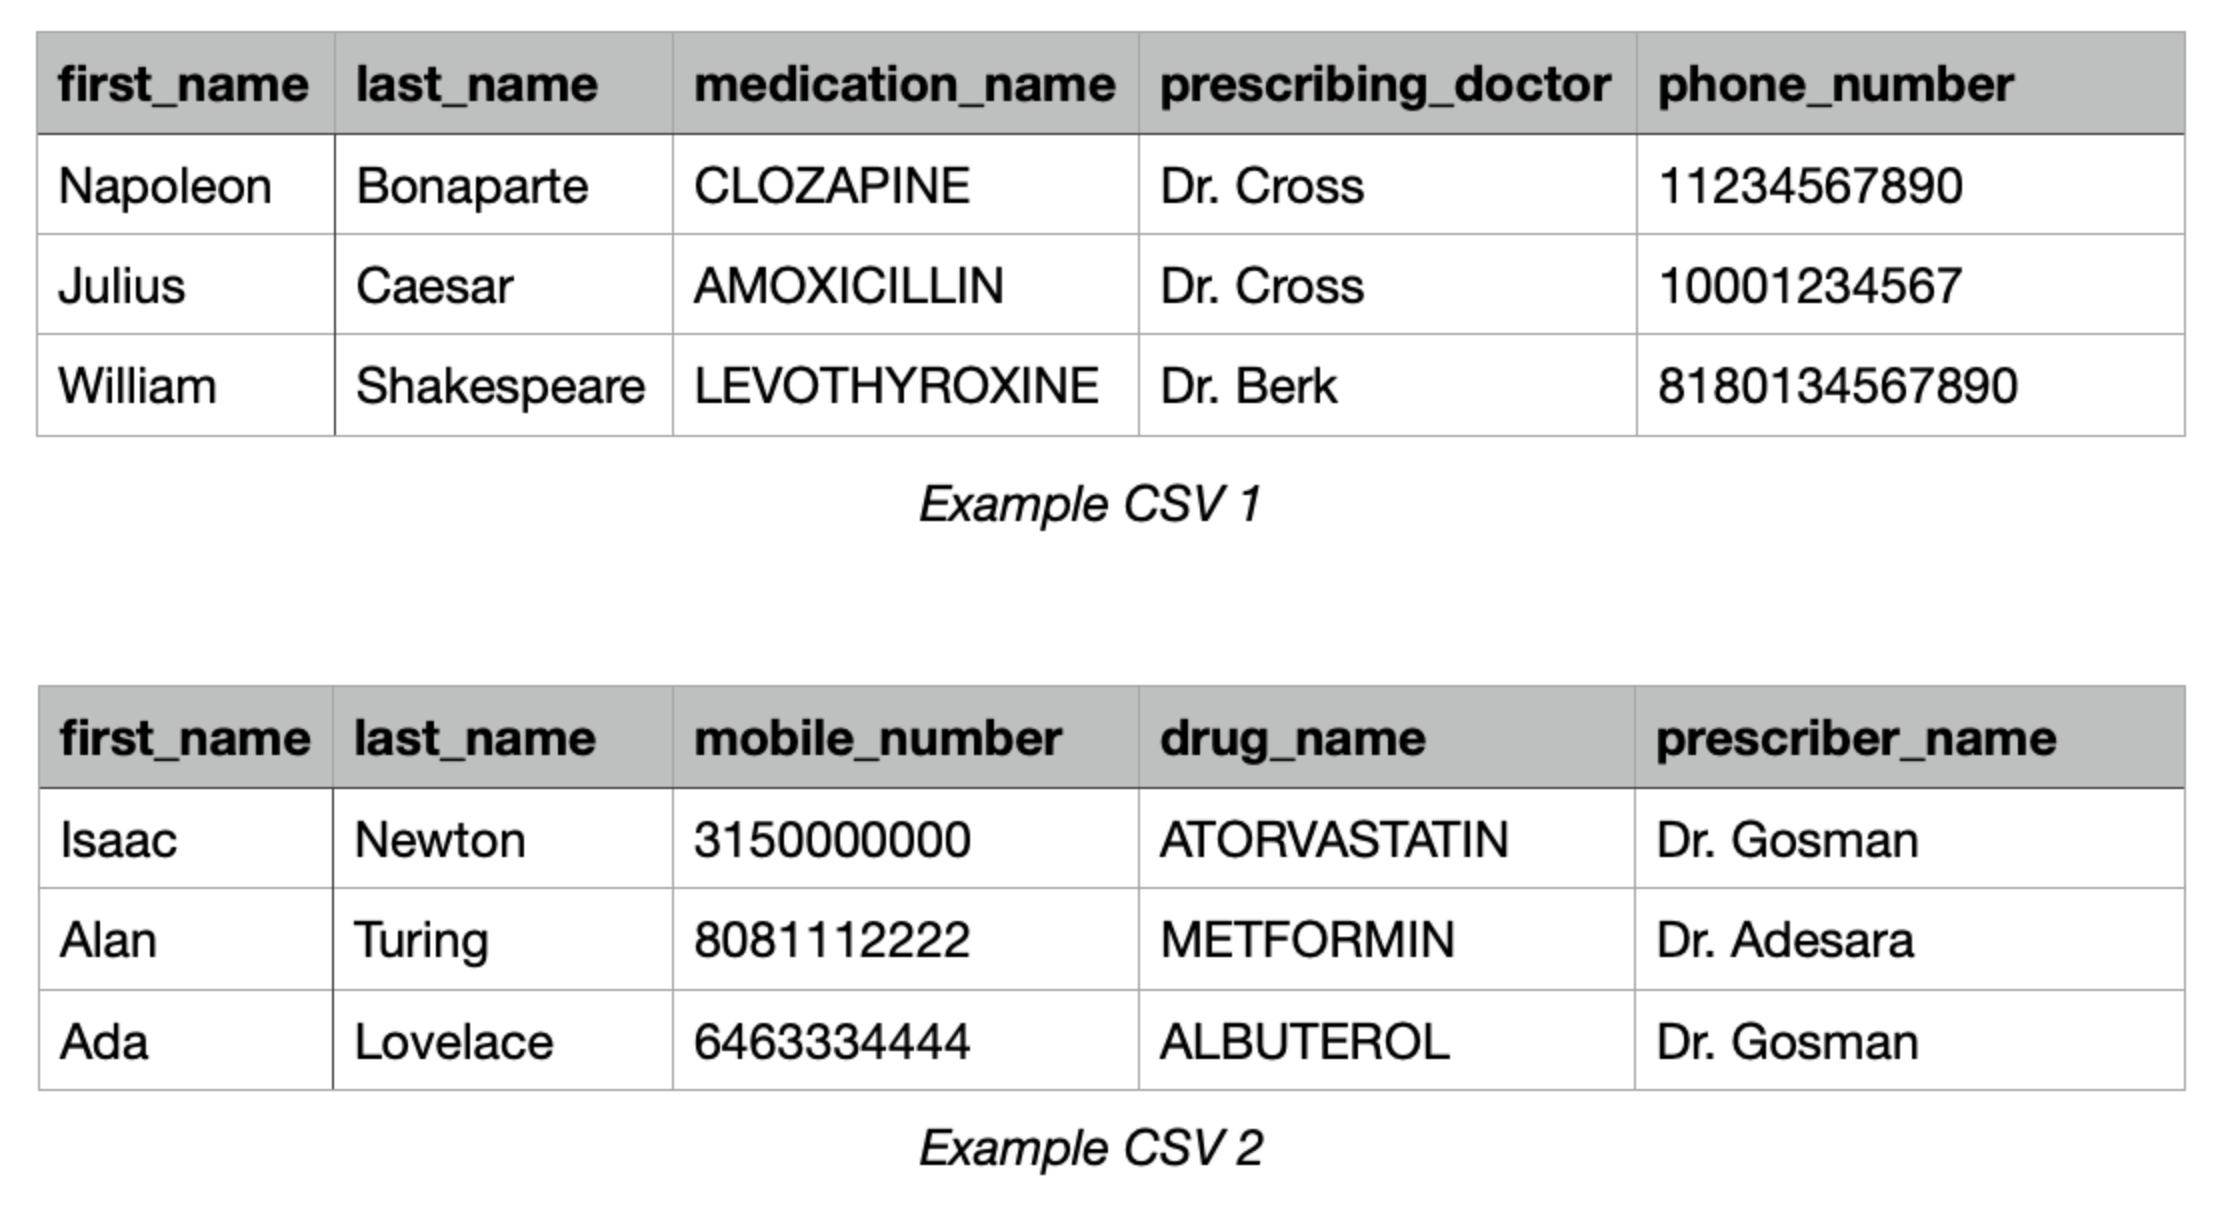
این مرحله پیش نیاز برای نوسازی در زنجیره است. به عنوان مثال ، مراحل کوتاه تر می تواند به طولی به اکتشافی تکیه کند. به عنوان مثال ، وقتی به شماره تلفن ها نگاه می کنیم ، مرحله بعدی ما ممکن است از شماره 10 رقمی انتظار داشته باشد ، که در مورد شماره تلفن های ایالات متحده مانند پروکسی برای تعیین اعتبار شماره تلفن وجود دارد. اگرچه این یک تغییر نسبتاً کوچک است ، اما استاندارد سازی قالب ها در این مرحله به طور قابل توجهی تمامیت داده ها را در مرحله بعدی بهبود می بخشد.
مرحله 3: سوابق نوسازی
اکنون می خواهیم سوابق را ضد عفونی کنیم. این دومین و بیشتر در اعتبار در اعتبارسنجی داده ها در برابر خطاهای رایج است. در اینجا ما دستورالعمل ها و قوانین قالب بندی بیشتری را برای ویژگی های داده اعمال می کنیم. این مرحله نیاز به کار بیشتری دارد که ممکن است بی فایده به نظر برسد وقتی ما ابزارهای حزبی سوم را در دسترس داریم که می تواند این کار را برای ما آسان کند. با این حال ، این مهم است زیرا با به حداقل رساندن تعداد تماس های API مورد نیاز در مرحله بعدی ، راندمان هزینه را افزایش می دهد.
به عنوان مثال ، در فضای بهداشتی ، بهداشتی مربوطه می تواند به کد ICD-10 ، یک کد دارویی ملی و یک کد CPT منجر شود. نام داروها ، شرایط و روشهای پزشکی نیز می تواند با مقایسه آنها با لیست در حال اجرا از سوابق معتبر که در داخل کشور نگهداری می شود ، در پایه کد شما تأیید شود.
ما با مثال خود از یک داروخانه و ستون شماره تلفن خاص تر ادامه می دهیم. در این مرحله ، این منجر به حذف کد کشور یک کشور کشور می شود و سپس بررسی می کند که بقیه شماره تلفن دارای طول 10 است. سپس لیستی از کدهای معتبر منطقه ایالات متحده را در برنامه خود ذخیره می کنیم و سه رقم اول را با این لیست مقایسه می کنیم. تمام سوابق موجود در این چک ها نامزدهای مرحله بعدی هستند و مواردی که ما نامعتبر شده ایم با پیشروی در جدول اصلی ما مسدود می شوند.
برخی از ابزارهای ساده اما مفید در اینجا ممکن است شامل عبارات منظم ، روشهای داخلی باشد که ارزیابی می کند که آیا ضبط الفبایی است یا جداول با کلیه موارد سوابق معتبر برای مقایسه داده های ورودی ایجاد می کند. در این روش می توانیم اطمینان حاصل کنیم که هرگونه اطلاعات با یک قالب استاندارد سازگار است همه داده در سراسر سازمان
مرحله 4: اعتبار سنجی داده ها
ما به مرحله پردازش داده ها رسیده ایم: اعتبار سنجی دقیق. در اینجا ما احتمالاً می خواهیم از API های خارجی برای اشخاص ثالث برای تأیید مشروعیت داده های مورد نظر استفاده کنیم. این امر به این دلیل است که API های شخص ثالث طیف گسترده ای از پیشنهادات را ارائه می دهند که می تواند زمان و منابع باورنکردنی برای ساختن موارد داخلی باشد. در مثال ما ، این به معنای استفاده از Twilio برای تأیید API ارائه دهنده ملی (NPI) برای بررسی نسخه ها است.
به عنوان مثال ، اگر می خواستیم آدرس بیمار را تأیید کنیم ، می توانیم از Google Maps API استفاده کنیم. با استفاده از این API ، ما همچنین می توانیم از جمله موارد دیگر ، ارتفاع مکان ، منطقه زمانی و جاده های مجاور را برای بهبود کیفیت محصولات خود برای محصولات به ارمغان بیاوریم.
مرحله 5: نظارت و هشدار ابزار
آخرین مرحله در این خط لوله مشاهده و هشدار است. اگرچه ممکن است این مرحله با کار درمانی واقعی داده ها ارتباط نداشته باشد ، اما به همان اندازه مهم است. این امر به این دلیل است که خط لوله تنها مفهوم استاتیک نیست. اخیراً ، این چرخه ای و تکراری است -هدف ایجاد یک چرخه بازخورد دقیق است تا تضمین کنیم که داده هایی که ما اعمال می کنیم برای کار مناسب ترین هستند و تمام پیشرفت های لازم در این خط لوله بلافاصله آشکار هستند تا بتوانیم به سرعت به پیشرفت برسیم.
در مثال ما از داروخانه ، ما می خواهیم زیرساخت های هشدار دهنده ای بسازیم تا اطمینان حاصل کنیم که درصدی از دستور العمل ها در حال اجرا است. سیستم نظارت ما باید تعداد درخواست های API ، اطلاعات مربوط به بیمار و توزیع کلی کدهای پاسخ HTTP را برای شناسایی هرگونه مشکل نشان دهد. بیایید بگوییم که هر بیمار نیاز به درخواست خود برای API دارد و ما هر روز درخواست هزاران درخواست را ارائه می دهیم ، هر یک به ارزش 1 دلار. شما به راحتی می توانید ببینید که چگونه داده های نادرست با کمی مشاهده می توانند بسیار گران شوند.
برخی از ابزارهایی که می توانیم در این مثال از نظارت و هشدار مداوم استفاده کنیم شامل ربات های ضعیف ، اعلان های ایمیل ، تابلوهای کنترل ساخته شده به سرعت در تعمیر و PageRduty برای حساسیت زمان/اولویت بالا است. اینها همه ابزاری است که می تواند برای کاهش هزینه ها ، مداخله زود هنگام مشکلات و اطمینان از حداکثر یکپارچگی داده ها استفاده شود.
پایان
استفاده از یکپارچگی داده ها در تمام سطوح در سازمان ، گام مهمی در جلوگیری از راه حل های گران قیمت در طول مسیر به دلیل استفاده غیر ضروری از ابزارهای شخص ثالث است. خط لوله تدریجی ، با شروع از عادی سازی تا بهداشت ، اعتبار سنجی و نظارت ، یک روش پایدار برای پردازش حجم های بزرگ از یک ورودی مبهم ارائه می دهد ، در حالی که سر را در پایین دست به حداقل می رساند.