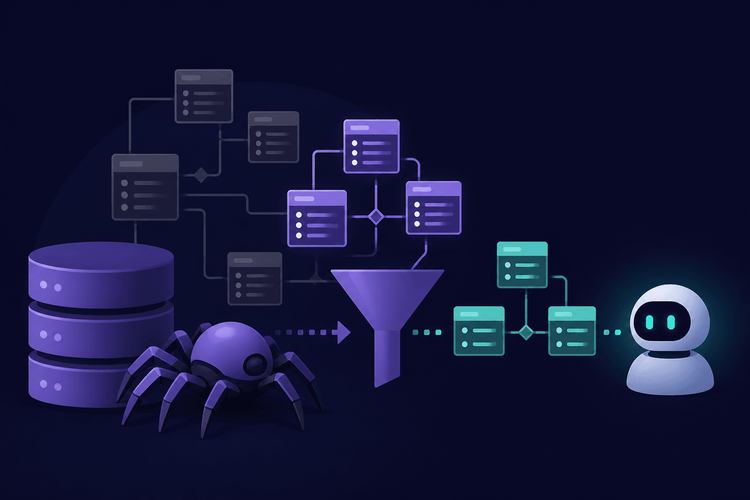
عوامل LLM که وظیفه تولید SQL یا استدلال در مورد مدل های داده رابطه ای را بر عهده دارند، برای تولید پرس و جوهای صحیح به زمینه طرحواره صحیح بستگی دارند. اما تغذیه ابرداده خام از یک پایگاه داده به یک اعلان یک ابزار خام است که به سرعت خراب می شود.
نحوه استخراج و برش طرحواره های DB برای زمینه LLM
- نصب کنید SchemaCrawler از طریق Docker یا Homebrew و اتصال به پایگاه داده هدف خود را بررسی کنید.
- استخراج کنید کاتالوگ کامل به صورت JSON ساختار یافته با استفاده از
--info-level=standardو--output-format json. - فیلتر کنید جداول به مرز دامنه شما با
--grep-tablesبا استفاده از یک عبارت منظم از نام جدول مربوطه. - خاموش کنید مسیرهای حسابرسی (مثلا
created_at،updated_at) از طریق--grep-columnsبا الگوی انتظار منفی - کاهش دهید کاتالوگ به زیرگراف مرتبط با کلید خارجی با استفاده از
--parents=1 --children=1پرچم های عمق - لباساتو در بیار نماها، روالها و مترادفها از طریق راهاندازی
--table-types=TABLEو--routine-types="". - فشرده JSON فیلتر شده در حداقل شبه DDL با اسکریپت پایتون برای به حداکثر رساندن تراکم توکن.
- تزریق کنید دریافت کرد
schema_context.txtدر اعلان سیستم LLM شما و در هر مهاجرت دوباره آن را در CI تولید کنید.
محتوا
مشکل انفجار طرحواره در LLM درخواست می کند
استخراج و حکاکی طرحواره های DB رابطه ای برای مصرف LLM یک مشکل راحت نیست. این یک مشکل نمادین اقتصادی و دقت است که با رشد پایگاه های داده ترکیب شده است.
این مقاله نسخه 16.22.3 SchemaCrawler را فرض می کند (دانلود از نسخه های GitHub). نصب بدون داکر به جاوا 11 یا جدیدتر نیاز دارد (
java -version). نصب داکر هیچ وابستگی محلی به جاوا ندارد. Python 3.x برای اسکریپت فشرده سازی و مثال ادغام OpenAI مورد نیاز است.
چرا خام pg_dump --schema-only در مقیاس شکست خورد
در حال اجرا pg_dump --schema-only در مقابل یک پایگاه داده تولیدی PostgreSQL یک DDL dump ایجاد می کند که شامل هر جدول، نمایش، دنباله، فهرست، محدودیت، مجوز، پیکربندی برنامه افزودنی و نظر در کاتالوگ است. برای یک برنامه متوسط با 200 جدول، این خروجی به طور معمول از 30000 توکن فراتر می رود که آن را با اندازه گیری می کنید. o200k_base رمزگذاری مورد استفاده توسط GPT-4o از طریق tiktoken (استفاده کنید cl100k_base برای GPT-4 یا GPT-3.5-turbo). این قبل از اضافه شدن یک سوال کاربر به درخواست است.
این dump همچنین شامل مصنوعات کاتالوگ سیستم، جداول قدیمی حفظ شده برای سازگاری با عقب، ستونهای اعتبارسنجی که تقریباً در هر جدول ظاهر میشوند و اشیاء خاص برنامه افزودنی غیرمرتبط با تولید پرس و جو میشود. هیچ یک از این نویزها به LLM کمک نمی کند تا SQL درست بنویسد. همه اینها از بودجه پنجره زمینه استفاده می کند و مدل را به سقف ورودی نزدیک می کند.
چگونه نویز طرحواره دقت متن به SQL را کاهش می دهد
نتایج حاصل از BIRD (Li et al., 2023) و Spider (Yu et al., 2018) نشان می دهد که دقت متن به SQL با افزایش تعداد جداول و ستون های نامناسب در طرحواره داده شده بدتر می شود. حالت شکست یک مشکل “سوزن در انبار کاه” است: مدل باید زیرمجموعه صحیح جداول را شناسایی کند و مسیرها را از یک تخلیه ابرداده بزرگ و تمایز نیافته بپیوندد. با تکثیر اشیاء نامناسب، احتمال ارجاع جدول توهم، اتصالات نادرست و نام ستون های ساختگی افزایش می یابد.
هر رویکردی که بیش از یک چرخه مهاجرت زنده بماند، نیازمند استخراج و برش خودکار، تکرارپذیر در سطح ابرداده است، نه در سطح متن DDL.
مدیریت دستی زیرمجموعه های طرحواره یک پاسخ است، اما در بین تیم های مهندسی مقیاس نمی شود و هر بار که مهاجرت جدولی را اضافه یا حذف می کند، شکسته می شود. هر رویکردی که بیش از یک چرخه مهاجرت زنده بماند، نیازمند استخراج و برش خودکار، تکرارپذیر در سطح ابرداده است، نه در سطح متن DDL.
آنچه SchemaCrawler به جدول می آورد
نمای کلی معماری
SchemaCrawler یک خزنده فراداده JDBC آفلاین است که به یک پایگاه داده متصل می شود، متادیتا را از کاتالوگ از طریق درایور JDBC می خواند. DatabaseMetaData API و خروجی ساخت یافته را در قالب های متعدد تولید می کند. از PostgreSQL، MySQL، SQLite، Oracle، SQL Server و بسیاری از پایگاه های داده اضافی پشتیبانی می کند (برای مجموعه کامل به لیست سازگاری رسمی مراجعه کنید).
مدل شی داخلی آن از یک سلسله مراتب پیروی می کند: کاتالوگ، طرحواره، جدول، ستون، کلید خارجی، فهرست و روال. در این نمایش مبتنی بر نمودار، جداول به عنوان گره و کلیدهای خارجی به عنوان یال های جهت دار عمل می کنند. این معماری مهم است. SchemaCrawler به جای کار بر روی متن خام DDL، یک گراف ابرداده تایپ شده را دستکاری می کند و عملیات فیلتر کردن، کاهش و خزیدن را فعال می کند که در صورت اعمال به یک DDL dump به تجزیه و تحلیل پیچیده نیاز دارد.
فرمت های خروجی شامل متن ساده، JSON، YAML، HTML و نمودارهای گرافیکی از طریق رندر DOT و PNG است. برای خطوط لوله LLM، JSON بسیار مفید است زیرا می تواند توسط یک ماشین تجزیه شود. از DOT یا PNG فقط برای بررسی انسانی استفاده کنید.
چرا SchemaCrawler بیش از گزینه ها
پرس و جو information_schema به طور مستقیم به نوشتن و نگهداری SQL نیاز دارد که در بین فروشندگان پایگاه داده متفاوت است. pg_dump خروجی در سطح متن بدون فیلتر داخلی زیر سطح طرحواره تولید می کند. ابزارهای درون نگری ORM مانند SQLAlchemy’s inspect ویژگی در اکوسیستم پایتون کار میکند، اما فاقد ترکیبپذیری در سطح CLI و منطق کاهش داخلی است.
چیزی که در مورد SchemaCrawler متمایز است این است که فیلتر، grep و کاهش مبتنی بر نمودار در سطح گراف ابرداده قبل از خروجی رخ می دهد. توسعه دهندگان می توانند کاتالوگ را به یک زیرگراف مرتبط با یک کلید خارجی کوتاه کنند، الگوهای ستونی خاص را حذف کنند، و تنها برش مربوطه را پخش کنند، همه با یک فراخوان فرمان واحد.
نصب و اتصال SchemaCrawler
نصب و راه اندازی سریع (Docker و Homebrew)
سریعترین راه برای اجرای SchemaCrawler از طریق تصویر رسمی Docker آن است که به یک نسخه خاص برای تکرارپذیری پیوست شده است:
docker run --rm -v $(pwd):/share \
  schemacrawler/schemacrawler:16.22.3 \
  /opt/schemacrawler/bin/schemacrawler.sh \
  --help
این تصویر ثابت را دانلود می کند و دایرکتوری فعلی را برای دسترسی به فایل منبع نصب می کند.
یک شیر آب Homebrew شخص ثالث برای کاربران macOS وجود دارد، اما توسط انجمن پشتیبانی میشود و ممکن است از نسخههای آن عقب بماند. قبل از اجرا بررسی کنید که شیر آب به روز باشد و به مسیر Docker یا نسخه های GitHub برگردید .zip اگر شکست بخورد:
brew tap schemacrawler/schemacrawler && brew install schemacrawler
schemacrawler --version
اتصال به PostgreSQL و MySQL
پارامترهای اتصال به عنوان پرچم های CLI ارسال می شوند. برای PostgreSQL:
schemacrawler --server postgresql \
  --host localhost --port 5432 \
  --database myapp_production \
  --user "$DB_USER" --password "$DB_PASSWORD" \
  --info-level=standard \
  --command schema
برای MySQL، مبادله کنید --server postgresql به --server mysql و پورت را تنظیم کنید:
schemacrawler --server mysql \
  --host localhost --port 3306 \
  --database myapp_production \
  --user "$DB_USER" --password "$DB_PASSWORD" \
  --info-level=standard \
  --command schema
نکته امنیتی:
--passwordاعتبارنامه ها را در لیست فرآیند قرار می دهد (ps aux)، در تاریخچه پوسته و در گزارش های CI. در سیستم های تولیدی یا اشتراکی، از الف استفاده کنید.pgpassفایل (PostgreSQL) یا فایل اعتبارنامه معادل و حذف--password. اسناد نسخه SchemaCrawler خود را برای گزینه های پیمایش رمز عبور مبتنی بر متغیرهای محیطی بررسی کنید. در صورت امکان، رمز عبور را از طریق صادر کنیدPGPASSWORDیا برای جلوگیری از افشای فهرستی از فرآیندها، از یک فایل اعتبار استفاده کنید.
اعتبارنامه ها باید از طریق متغیرهای محیطی یا فایل های اعتباری مبتنی بر پایگاه داده مانند .pgpass برای PostgreSQL، در اسکریپت ها کدگذاری نشده است. اطمینان حاصل کنید که JAR درایور مناسب JDBC در دسترس است. تصویر Docker شامل درایورهای رایج است، اما نصب مستقل ممکن است نیاز به دانلود درایور جداگانه داشته باشد.
ایجاد یک کاتالوگ اساسی JSON
برای ایجاد یک نمایش کامل JSON از کاتالوگ پایگاه داده:
schemacrawler --server postgresql \
  --host localhost --port 5432 \
  --database myapp_production \
  --user "$DB_USER" --password "$DB_PASSWORD" \
  --info-level=standard \
  --command schema \
  --output-format json \
  --output-file catalog.json
فایل JSON به دست آمده حاوی کلیدهای سطح بالایی است که جداول، ستونها، کلیدهای خارجی، فهرستها و روالها را نشان میدهند. هر شی جدول شامل نوع داده خود و تعاریف ستون قابل تنظیم مجدد، محدودیت های کلید اولیه و مراجع کلید خارجی با شناسه های جدول والد و فرزند است. خروجی ساختاریافته چیزی است که فیلتر کردن پایین دست را بدون تجزیه متن ممکن می کند.
قبل از ایجاد هر خط لوله پایین دستی بر روی خروجی JSON، ساختار را با نسخه SchemaCrawler بررسی کنید. کلیدهای سطح بالا را با: python3 -c "import json,sys; d=json.load(sys.stdin); print(list(d.keys()))"
انتخاب سطح مناسب اطلاعات
را --info-level flag میزان فراداده ای که SchemaCrawler از درایور JDBC بازیابی می کند را کنترل می کند. در standard، خروجی شامل جداول، ستون ها، کلیدهای اصلی، کلیدهای خارجی و شاخص ها می باشد. در maximum، علاوه بر این، محرک ها، امتیازات، بدنه های معمول و حاشیه نویسی جدول/ستون را استخراج می کند.
برای ایجاد یک زمینه LLM، standard انتخاب درستی است مگر اینکه به ابرداده های ماشه یا امتیاز نیاز داشته باشید. خروجی اضافی از maximum تعداد توکن ها را به میزان قابل توجهی افزایش می دهد و به ندرت به دقت تولید SQL کمک می کند. جزئیات راهاندازها، کمکها، و امتیازات نویز در یک گردش کار متن به SQL است. رزرو کنید maximum برای تولید اسناد ممیزی امنیتی یا موارد استفاده.
طرح های فیلتر و برش برای زمینه LLM
فیلتر کردن جدول و ستون مبتنی بر Grep
برای گنجاندن تنها جداول منطبق با مرز دامنه شناخته شده، یک عبارت منظم جاوا را به آن ارسال کنید --grep-tables:
schemacrawler --server postgresql \
  --host localhost --port 5432 \
  --database myapp_production \
  --user "$DB_USER" --password "$DB_PASSWORD" \
  --info-level=standard \
  --command schema \
  --output-format json \
  --grep-tables "orders|products|customers|inventory" \
--output-file filtered_catalog.jsonستونهای ممیزی و حذف نرم که تقریباً در هر جدول ظاهر میشوند، سربار نمادین را بدون ارزش ساختاری اضافه میکنند. را --grep-columns flag یک فیلتر شامل است: ستون هایی را حفظ می کند که نام های کاملاً واجد شرایط با الگو مطابقت دارد. نگاه منفی به آینده به عنوان ^(?!.*(created_at|...)).*$ همه نام ستونها را که حاوی پسوندهای چک نیستند، مطابقت میدهد و به طور موثر آن ستونها را حذف میکند:
schemacrawler --server postgresql \
  --host localhost --port 5432 \
  --database myapp_production \
  --user "$DB_USER" --password "$DB_PASSWORD" \
  --info-level=standard \
  --command schema \
  --output-format json \
  --grep-columns "^(?!.*(created_at|updated_at|deleted_at)).*$" \
  --output-file lean_catalog.json
این مدل تمام ستونها را حفظ میکند، به جز ستونهایی که با نام ستونهای چک مطابقت دارند، و هزینه توکن در جدول را بدون از دست دادن اطلاعات ساختاری کاهش میدهد.
طرح کاهش با --parents و --children
را --parents و --children پرچم های عمق کاهش گراف را کنترل می کنند. پس از فیلتر کردن grep جداول seed را شناسایی می کند، با اضافه کردن --parents=1 --children=1 تمام لبه های کلید خارجی را در یک سطح خارج از این جداول خروجی می دهد و هر جدولی را که از طریق نمودار FK قابل دسترسی نیست، حذف می کند. کاهنده به طور خودکار جداول یتیم (جدول های بدون روابط کلید خارجی با هر جدول دیگری در طرحواره)، جداول جستجوی بدون رابطه FK با مجموعه دانه، و جداول دامنه نامرتبط را حذف می کند.
schemacrawler --server postgresql \
  --host localhost --port 5432 \
  --database myapp_production \
  --user "$DB_USER" --password "$DB_PASSWORD" \
  --info-level=standard \
  --command schema \
  --output-format json \
  --grep-tables "orders" \
  --parents=1 --children=1 \
  --output-file orders_subgraph.json
زیرگراف متصل به FK حاصل در ریشه دارد orders جدول معمولا شامل جداول مرتبط مانند customers، order_items، products، و payments بدون نیاز به شمارش صریح مقادیر عمق را برای گسترش یا جمع کردن زیرگراف در صورت نیاز تنظیم کنید.
نماها، روالها و مترادفها را حذف کنید
پرچم های اضافی انواع شی را که به ندرت متن را به SQL کمک می کنند حذف می کنند:
--table-types=TABLE --routine-types=""راه اندازی --routine-types="" به یک مقدار خالی همه رویه ها و توابع ذخیره شده را غیرفعال می کند. راه اندازی --table-types=TABLE دیدگاه ها، دیدگاه های مادی شده و مترادف ها را استثنا نمی کند. استثنا: زمانی که درخواست های گزارش شما دیدگاه های تحقق یافته ای را هدف قرار می دهد که نماینده LLM باید ارسال کند. در چنین حالتی، مقدار را نقل قول کنید تا از مشکلات جداسازی کلمات در لفاف جلوگیری شود: --table-types="TABLE,MATERIALIZED VIEW".
ساخت یک فایل پیکربندی قابل استفاده مجدد
قوانین فیلتر را در یک فایل پیکربندی که در کنترل نسخه بررسی شده است، کپسوله کنید. فرمت را بررسی کنید (.properties یا YAML) توسط نسخه SchemaCrawler شما قبل از استفاده از این روش پشتیبانی می شود. موارد زیر هدف را نشان می دهد:
command: schema
output-format: json
info-level: standard
table-types: TABLE
routine-types: ""
grep-tables: "orders|products|customers|inventory|payments|order_items"
grep-columns: "^(?!.*(created_at|updated_at|deleted_at|modified_by)).*$"
parents: 1
children: 1
فایل پیکربندی قرارداد سطح پروژه را تعریف می کند که زیرمجموعه طرحواره به LLM می رسد، که می تواند در درخواست های کشش همراه با فایل های مهاجرت مشاهده شود.
خروجی فشرده برای کارایی توکن
انتخاب حداقل قالب سریال
خروجیهای JSON و YAML ابردادههای ساختاری را حفظ میکنند که برای مصرف برنامهریزی مفید هستند اما به طور نمادین گران هستند. یک قالب فشرده شبه DDL که فقط نام جدول، نام ستون، انواع داده و حاشیه نویسی PK/FK را منتشر می کند، به بالاترین چگالی توکن دست می یابد و در عین حال برای LLM های آموزش دیده با SQL قابل خواندن باقی می ماند.
یک اسکریپت پایتون که از طریق یک لوله پوسته نامیده می شود، کاتالوگ JSON را به DDL حداقل تبدیل می کند:
import json
import sys

try:
    catalog = json.load(sys.stdin)
except json.JSONDecodeError as exc:
    print(f"ERROR: Failed to parse JSON input: {exc}", file=sys.stderr)
    sys.exit(1)

tables = catalog.get("all-tables", [])
if not tables:
    print(
        "WARNING: No tables found. Verify 'all-tables' key matches your "
        "SchemaCrawler version output.",
        file=sys.stderr,
    )

for table in tables:
    tname = table.get("name")
    if not tname:
        print("WARNING: Skipping table with missing 'name' field.", file=sys.stderr)
        continue

    cols = []
    for col in table.get("columns", []):
        col_name = col.get("name")
        data_type_obj = col.get("column-data-type")
        data_type = data_type_obj.get("name") if isinstance(data_type_obj, dict) else None

        if not col_name or not data_type:
            print(
                f"WARNING: Skipping column with missing name or type in table '{tname}'.",
                file=sys.stderr,
            )
            continue

        cdef = f"  {col_name} {data_type}"
        if col.get("part-of-primary-key"):
            cdef += " PK"
        if col.get("part-of-foreign-key"):
            cdef += " FK"
        cols.append(cdef)

    if not cols:
        cols = ["  -- no columns"]

    print(f"CREATE TABLE {tname} (")
    print(",
".join(cols))
    print(");
")
معیارهای تراکم توکن
تعداد توکن ها یک تخمین گویا است که در برابر فهرست داخلی استفاده اندازه گیری می شود tiktoken. نتایج واقعی بر اساس طرح متفاوت خواهد بود. کاتالوگ خود را با:
python3 -c "
import tiktoken
enc = tiktoken.get_encoding('o200k_base')
with open('output.txt', encoding='utf-8') as f:
    content = f.read()
print(len(enc.encode(content)))
"| رویکرد | جداول گنجانده شده است | نشانه ها (تصویری) | کاهش در مقابل خام |
|---|---|---|---|
خام pg_dump --schema-only |
247 | ~ 34200 | – |
| SchemaCrawler JSON (استاندارد) | 247 | 22800 ~ | ~ 33٪ |
| SchemaCrawler JSON + grep + کاهش | 18 | ~2400 | ~ 93٪ |
| شبه DDL فشرده (اسکریپت شده) | 18 | ~ 1100 | ~ 97٪ |
خط لوله ترکیبی grep، کاهش گراف، و قالب بندی فشرده تقریباً 97٪ کاهش را نسبت به خط پایه تخلیه خام در این مثال به دست می آورد. در حدود 1100 توکن، قطعه شماتیک مربوطه به راحتی در یک سیستم اعلان به همراه دستورالعمل ها و چندین نمونه عکس قرار می گیرد و فضای زیادی برای درخواست کاربر و پاسخ مدل باقی می گذارد.
ادغام خط لوله در یک گردش کار عامل LLM
اسکریپت خط لوله CLI
#!/usr/bin/env bash

set -euo pipefail

SCRIPT_DIR="$(dirname "$0")"

DB_HOST="${DB_HOST:-localhost}"
DB_PORT="${DB_PORT:-5432}"
DB_NAME="${DB_NAME:-myapp_production}"
DB_USER="${DB_USER:-postgres}"
DB_PASSWORD="${DB_PASSWORD:?Error: DB_PASSWORD environment variable must be set}"


TMPFILE="$(mktemp)"
trap 'rm -f "$TMPFILE"' EXIT


export PGPASSWORD="$DB_PASSWORD"


schemacrawler --server postgresql \
  --host "$DB_HOST" --port "$DB_PORT" \
  --database "$DB_NAME" \
  --user "$DB_USER" \
  --info-level=standard \
  --table-types=TABLE \
  --routine-types="" \
  --grep-tables "orders|products|customers|inventory|payments|order_items" \
  --grep-columns "^(?!.*(created_at|updated_at|deleted_at)).*$" \
  --parents=1 --children=1 \
  --command schema \
  --output-format json \
  --output-file "$TMPFILE"


python3 "$SCRIPT_DIR/compact_schema.py"  "$TMPFILE" > schema_context.txt

echo "Schema context written to schema_context.txt ($(wc -c  schema_context.txt | xargs) bytes)"
مرحله 1 SchemaCrawler را با تمام فیلترها و کاهش پرچم ها اجرا می کند و یک فایل JSON میانی را در یک مکان موقت خصوصی ایجاد می کند. مرحله 2 این JSON را از فشرده ساز پایتون عبور می دهد تا حداقل فرمت DDL را منتشر کند. فینال schema_context.txt آرتیفکتی است که به دستورات LLM تزریق می شود. را trap تضمین می کند که فایل موقت پاک می شود، حتی اگر اسکریپت به دلیل یک خطا پیش از موعد خارج شود.
ادغام پایتون با OpenAI
import os
import sys
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])

schema_path = "schema_context.txt"
try:
    with open(schema_path, encoding="utf-8") as f:
        schema_context = f.read()
except FileNotFoundError:
    print(
        f"ERROR: Schema context file '{schema_path}' not found. "
        "Run extract_schema_context.sh first.",
        file=sys.stderr,
    )
    sys.exit(1)

system_message = (
    "You are a SQL assistant. Use the following database schema to write "
    "accurate PostgreSQL queries. Only reference tables and columns that "
    "appear in the schema.

"
    f"{schema_context}"
)

user_query = (
    sys.argv[1]
    if len(sys.argv) > 1
    else "What are the top 10 customers by total order value in the last 30 days?"
)

try:
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": system_message},
            {"role": "user", "content": user_query},
        ],
        temperature=0,
        timeout=30,
    )
except Exception as exc:
    print(f"ERROR: OpenAI API call failed: {exc}", file=sys.stderr)
    sys.exit(1)

if not response.choices:
    print("ERROR: API returned no choices. Check content filters or API status.", file=sys.stderr)
    sys.exit(1)

print(response.choices[0].message.content)
برای تیم هایی که از LangChain استفاده می کنند، schema_context.txt می تواند مکمل یا تا حدی جایگزین مولفه استخراج طرحواره شود SQLDatabaseToolkit، کنترل دقیق تری بر فراداده هایی که عامل می بیند می دهد. این مدل با هر API سازگار با OpenAI کار می کند.
تازه نگه داشتن زمینه در CI/CD
هر زمان که طرح پایگاه داده تغییر کرد، مصنوعات زمینه طرحواره را بازسازی کنید. خط لوله استخراج را بهعنوان یک کار CI که توسط رویدادهای مهاجرت ایجاد میشود اجرا کنید تا طرحواره فشرده را همگام کنید. اسکریپت خط لوله را می توان به عنوان یک مرحله پس از مهاجرت در ابزارهایی مانند Flyway یا Alembic نامید.
یک استراتژی عملی برای باطل کردن حافظه پنهان: خروجی کاتالوگ زنده را هش کنید و آن را با هش ذخیره شده قبلی مقایسه کنید. خط لوله تنها زمانی بازسازی می شود که هش تغییر کند و از حلقه های غیرضروری CI در پیاده سازی های بدون طرح جلوگیری شود. نسخه دریافت شد schema_context.txt همراه با فایل های مهاجرت، به طوری که هر commit که طرحواره را تغییر می دهد، مصنوع زمینه LLM را نیز به روز می کند.
مسائل، محدودیت ها و نکات
موارد لبه برای تماشا
اگر الگوی grep فقط یک طرح را هدف قرار دهد، کلیدهای خارجی بین طرحوارههای مختلف در پایگاههای داده چند کاتالوگ میتوانند باعث شوند که پرچمهای کاهش گراف جداول مرتبط را از دست بدهند. گنجاندن صریح همه طرحهای مرتبط در الگوهای bind و grep از شکافهای بیصدا جلوگیری میکند.
اگر LLM تولید کند WHERE status="active" اما ستون یک enum است و مدل مقادیر معتبر را نمیداند، ممکن است پرس و جو شکست بخورد یا چیزی برگرداند. انواع Enum و دامنه های کاربر به طور کامل ثبت نشده اند standard سطح اطلاعات برای نمایش مقادیر enum معتبر، به آن بروید --info-level=maximum برای آن واکشی های خاص یا به صورت دستی زمینه را گسترش دهید. توجه داشته باشید که مقدار enum از طریق JDBC گرفته می شود getColumns بستگی به راننده دارد این رفتار را با ارائه دهنده پایگاه داده خود و نسخه SchemaCrawler بررسی کنید.
بدنه های معمولی بزرگ منبع رایج تورم تولید هستند. همیشه تنظیم شده --routine-types="" برای flush مگر اینکه رویه های ذخیره شده به صراحت بخشی از هدف تولید پرس و جو باشند.
زمانی که SchemaCrawler کافی نیست
بازیابی طرحواره ایستا برای دامنه های پایدار که مجموعه جداول مربوطه از قبل شناخته شده است، به خوبی کار می کند. برای برنامههایی که زیرمجموعه مناسب طرحوارهها به درخواست کاربر در زمان اجرا بستگی دارد، رویکرد Retrieval Augmented Generation (RAG) بر روی جاسازی طرحواره، انتخاب پویا را فراهم میکند.
تقویت طرح مشتق شده با توضیحات سطح ستون یا ابرداده از فرهنگ لغت کسب و کار، ارجاعات ستون توهم آمیز را زمانی که نام ستون ها مبهم هستند کاهش می دهد (مثلاً چندین جدول با
statusستون).
تقویت طرح مشتق شده با توضیحات سطح ستون یا ابرداده از فرهنگ لغت کسب و کار، ارجاعات ستون توهم آمیز را زمانی که نام ستون ها مبهم هستند کاهش می دهد (مثلاً چندین جدول با status ستون). جفت کردن استخراج طرحواره با تجزیه و تحلیل گزارش پرس و جو برای اولویت بندی جداول که اغلب به هم متصل می شوند، اصلاح دیگری است که استراتژی برش را از ساختاری (گراف FK) به مبتنی بر استفاده تغییر می دهد.
بعدش چی میاد
توسعه دهندگان باید خط لوله را با کاتالوگ های خود مقایسه کنند، تعداد توکن ها را اندازه گیری کنند tiktokenو الگوهای grep را روی مرزهای دامنه آنها تنظیم کنید. اسناد SchemaCrawler و مخزن GitHub آن یک مرجع کامل برای پیکربندی پیشرفته و فرمت های خروجی اضافی ارائه می دهد.
Source link