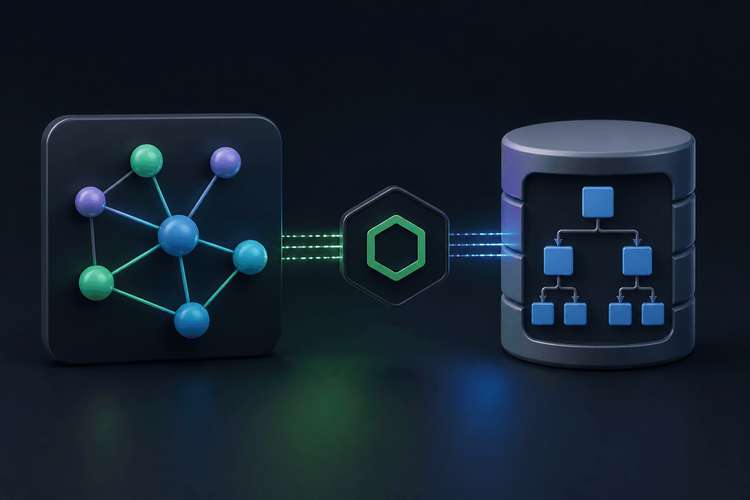
در این مقاله به بررسی نحوه ایجاد یک سیستم تولید (RAG) با استخراج استفاده از خودزمان می پردازیم گره گایا برای نتیجه گیری LLM و تعبیه شده ، کرومادب به عنوان یک پایگاه داده بردار محلی و لانگچین به ارکستر کل فرآیند. این رویکرد “محلی” از نظر کنترل ، محرمانه بودن و راندمان احتمالی هزینه مزایای قابل توجهی دارد.
مشکل اصلی: فراتر از دانش استاتیک
LLM ها فوق العاده قدرتمند هستند ، اما دانش آنها معمولاً به داده های یادگیری آنها محدود می شود. برای برنامه های دنیای واقعی ، شما اغلب به آنها نیاز دارید تا دسترسی داشته باشند و فکر کنند داده های خاص ، up -to -date یا خصوصی شماS اینجا جایی است که یک پارچه می آید.
سیستم های Rag از:
- استخراج: برای اطلاعات مربوط به درخواست کاربر ، یک پایگاه دانش (اسناد خود) جستجو کنید.
- افزایش: تزریق این اطلاعات بازیابی شده در یک سریع LLM.
- نسل: سپس LLM بر اساس دانش عمومی خود پاسخی ایجاد می کند وت زمینه ارائه شده
کلید استخراج مؤثر نهفته است پایگاه داده های بردار وت ترکیبحرف
جعبه ابزار ما: Gaia Knot ، Chromadb و Langchain
بیایید به سرعت شخصیت ها را در مجموعه خود معرفی کنیم:
- گره گایا: سرور شخصی ، قدرتمند LLM و ساخته شده شما. گره گایا فراهم می کند API سازگار با اوپایابزارها و کتابخانه های اهمیت که برای API OpenAi (مانند Langchain) طراحی شده اند می توانند یکپارچه به مدل های خود محرک شما متصل شوند. این امر به شما کنترل بی نظیری بر مدل های مورد استفاده شما می دهد و داده های شما در کجا قرار دارد.
- Chromadb: سبک ، کد باز پایگاه داده بردار برای سادگی و سهولت استفاده طراحی شده است. این امکان را به شما می دهد تا ایده های عددی (جاسازی) از داده های متن خود را ذخیره کرده و به سرعت در جستجوی شباهت باشید. مهمترین چیز این است که Chromadb از آن پشتیبانی می کند پشتکار محلیاین بدان معنی است که پایگاه داده بردار شما می تواند روی دیسک ذخیره شود و شارژ شود و از پردازش اضافی جلوگیری شود.
- Langchain: یک قاب همه کاره که توسعه برنامه های LLM را ساده می کند. این انتشارات سطح بالا برای اجزای مشترک (LLMS ، ساخته شده ، در لودرهای اسناد ، فروشگاه های بردار) و روش های هوشمندانه برای زنجیره ای آنها برای ایجاد فرآیندهای کاری پیچیده مانند سیستم RAG ما فراهم می کند.
هدف از پروژه: سوالی که مربوط به اسناد شما است
هدف ما ساختن سیستمی است که می تواند به سؤالات مربوط به یک سند متنی پاسخ دهد (به عنوان مثال ، آدرس دولت اتحادیه). ما خواهیم کرد:
- سند را به قطعات قابل کنترل بارگذاری و تقسیم کنید.
- این قطعات را با استفاده از گره Gaia به “جاسازی شده” عددی تبدیل کنید.
- این موارد تعبیه شده را در فروشگاه بردار Chromadb نگه دارید.
- وقتی از یک سؤال پرسیده شد ، مناسب ترین قطعات Chromadb را دریافت کنید.
- این قطعات مربوطه و سؤال را به LLM (همچنین یک گره GAIA) ارسال کنید تا یک پاسخ کوتاه ایجاد کنید.
به کد شیرجه بزنید (demo.py)
بیایید از طریق اسکریپت پایتون که کل مراحل را سازماندهی می کند ، برویم.
1. پیکربندی: به گره GAIA متصل شوید
اولین قدم این است که به Langchain بگویید که چگونه با گره Gaia خود صحبت کنید.
# Configuration for Gaia Node
GAIA_NODE_URL = "https://0x5ee30a31554672a0c213ed38e8898de84c2bb34b.gaia.domains" # Replace with your Gaia node URL
GAIA_API_KEY = "gaia" # Replace with your Gaia API key

# Set up environment variables for OpenAI-compatible API
os.environ["OPENAI_API_BASE"] = f"{GAIA_NODE_URL}/v1"
os.environ["OPENAI_API_KEY"] = GAIA_API_KEY
با تنظیم OPENAI_API_BASE وت OPENAI_API_KEY متغیرهای محیطی ، لانگچین OpenAIEmbeddings وت ChatOpenAI کلاس ها به طور خودکار درخواست های خود را به URL روشن شده GAIA شما هدایت می کنند. این باعث می شود گره سفارشی شما دقیقاً مانند API Openai از دیدگاه Langchain رفتار کند.
2. تست اتصال: تأیید اتصال گره Gaia
قبل از انجام کار پیچیده ، حیاتی است که اطمینان حاصل کنید که گره Gaia شما به کار رفته و کار می کند و به درستی به درخواست های نصب و LLM پاسخ می دهد.
from langchain_openai import OpenAIEmbeddings, ChatOpenAI

def test_gaia_connection():
    print("Testing Gaia Node connection...")
    try:
        # Test embeddings
        embedding = OpenAIEmbeddings(
            base_url=os.environ["OPENAI_API_BASE"],
            api_key=os.environ["OPENAI_API_KEY"],
            model="Nomic-embed-text-v1.5" # Specify your embedding model
        )
        test_text = "This is a test sentence."
        result = embedding.embed_query(test_text)
        print(f"✓ Embeddings working - dimension: {len(result)}")

        llm = ChatOpenAI(
            base_url=os.environ["OPENAI_API_BASE"],
            api_key=os.environ["OPENAI_API_KEY"],
            model="Llama-3-Groq-8B-Tool-Use-Q5_K_M" # Specify your chat model
        )
        response = llm.invoke("Say hello!")
        # IMPORTANT: Access .content for the string output from AIMessage
        print(f"✓ LLM working - response: {response.content[:50]}...")
        return True
    except Exception as e:
        print(f"✗ Connection failed: {e}")
        return False
این ویژگی دو چک مهم را انجام می دهد:
- شروع کردن
OpenAIEmbeddings(چه کسی از گره GAIA شما استفاده خواهد کرد) و تلاش می کند یک جمله ساده را تعبیه کند. این نقطه پایان نصب را بررسی می کند. - سپس اولیه سازی کنید
ChatOpenAI(دوباره ، با استفاده از گره Gaia خود) و اصلی “سلام سلام!” برانگیخت
5. اسناد بارگیری و پردازش: آماده سازی ورود
اسناد بزرگ باید به موارد کوچکتر شکسته شوند که به دنبال قطعات هستند.
from langchain_community.document_loaders import TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter

def load_and_process_documents(file_path):
    loader = TextLoader(file_path)
    documents = loader.load()

    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=1000,
        chunk_overlap=200 # Overlap helps maintain context across chunks
    )
    texts = text_splitter.split_documents(documents)
    print(f"Document split into {len(texts)} chunks")
    return texts
TextLoader این فقط محتوای سند شما را بار می کند. RecursiveCharacterTextSplitter روشی هوشمندانه برای شکستن متن است. او سعی می کند بر اساس تقسیم کننده های معمولی (مانند پاراگراف ، جملات ، کلمات) تقسیم شود تا قطعات معنی دار را در کنار هم نگه دارد. chunk_size اندازه هر قطعه را محدود می کند و chunk_overlap این تضمین می کند که برخی از زمینه ها از انتهای یک قطعه در ابتدای بعدی منتقل می شود و از از دست دادن اطلاعات در نقاط جداگانه جلوگیری می کند.
4. ایجاد/بارگیری یک پایگاه داده بردار: ذخیره سازی با Chromadb
اینجاست که بازی Chromadb ، ماهیت عددی اسناد ما را ذخیره می کند.
from langchain_community.vectorstores import Chroma

def create_vector_database(texts, persist_directory='gaia_chroma_db'):
    print("Creating embeddings using Gaia Node...")
    embedding = OpenAIEmbeddings( # Gaia Node generates these embeddings
        base_url=os.environ["OPENAI_API_BASE"],
        api_key=os.environ["OPENAI_API_KEY"],
        model="Nomic-embed-text-v1.5"
    )
    vectordb = Chroma.from_documents(
        documents=texts,
        embedding=embedding,
        persist_directory=persist_directory # Data is saved here!
    )
    print(f"Vector database created with {len(texts)} documents")
    return vectordb, embedding

def load_existing_database(persist_directory='gaia_chroma_db'):
    print(f"Loading existing database from {persist_directory}")
    # Must use the SAME embedding model as during creation
    embedding = OpenAIEmbeddings(
        base_url=os.environ["OPENAI_API_BASE"],
        api_key=os.environ["OPENAI_API_KEY"],
        model="Nomic-embed-text-v1.5"
    )
    vectordb = Chroma(
        persist_directory=persist_directory,
        embedding_function=embedding
    )
    print("Database loaded successfully")
    return vectordb, embedding
-
create_vector_database: این ویژگی متن شما را می گیردchunksمورد استفادهOpenAIEmbeddings(با استفاده از گره GAIA) برای تبدیل هر نوع کوتاه به بردار متکبر. این بردارها به همراه متن اصلی خود در Chromadb ذخیره می شوند. اوpersist_directoryاین استدلال برای عملکرد محلی پایداری Chroma مهم است – دایرکتوری را ایجاد می کند که در آن پایگاه داده بردار شما حفظ می شود. -
load_existing_database: اگرpersist_directoryاین در حال حاضر از یک چرخه قبلی وجود دارد ، این ویژگی به طور موثری پایگاه داده از پیش محاسبه شده از دیسک را شارژ می کند. این امر باعث صرفه جویی در وقت زیادی می شود و از نیاز به ورود مجدد به همه اسناد جلوگیری می کند. بسیار مهم استembedding_functionارائه شده در اینجا همزمان با استفاده در هنگام ایجاد است ، بنابراین Chroma می داند چگونه بردارهای ذخیره شده را تفسیر و مقایسه کند.
5. ایجاد زنجیره QA: ارکستر RAG
زنجیرهای Langchain جریان کار پیچیده LLM را ساده می کند. ما در اینجا استفاده می کنیم RetrievalQA برای خط لوله RAG ما
from langchain.chains import RetrievalQA

def create_qa_chain(vectordb):
    print("Initializing QA chain with Gaia Node...")
    # Again, use ChatOpenAI for chat models!
    llm = ChatOpenAI(
        base_url=os.environ["OPENAI_API_BASE"],
        api_key=os.environ["OPENAI_API_KEY"],
        model="Llama-3-Groq-8B-Tool-Use-Q5_K_M", # Your specific chat model
        temperature=0.7 # Controls creativity
    )
    qa = RetrievalQA.from_chain_type(
        llm=llm,
        chain_type="stuff", # Combines all retrieved docs into one prompt
        retriever=vectordb.as_retriever(), # ChromaDB becomes our retriever
        return_source_documents=True # Get sources back with answer
    )
    print("QA chain created successfully")
    return qa
- اولیه سازی LLM: ما LLM خود را با استفاده از
ChatOpenAIتضمین می کند که او به درستی با نقطه پایان فارغ التحصیلی چت گره Gaia ارتباط برقرار می کند. این آخرین قطعه معما بود که اجازه می داد405خطاها در طول پردازش واقعی درخواست ها. -
vectordb.as_retriever(): این روش باعث می شود که کرومادب ما را در یک مؤلفه که می تواند به دنبال شباهت باشد ، کپی کند. هنگامی که یک درخواست وارد می شود ، او از Chroma می پرسد: “قطعات سندی را که بیشتر شبیه این درخواست است ، برای من پیدا کنید.” -
chain_type="stuff": این یک استراتژی ساده برایRetrievalQAS تمام قطعات مشتق شده از سند ، “مواد” را در یک زمینه از بین می برد و سپس این زمینه ترکیبی را به همراه سؤال کاربر به LLM منتقل می کند. -
return_source_documents=Trueبه ما اجازه می دهد تا ببینیم بخش هایی از سند LLM برای تدوین پاسخ خود از کدام استفاده می کند و شفافیت را اضافه می کند.
6. گردش کار اساسی: جمع آوری همه چیز با هم
او main این ویژگی همه چیز را به هم متصل می کند و جریان را از ایجاد/بارگیری پایگاه داده به درخواست های کاری پردازش می کند.
def main():
    document_path = 'state_of_the_union.txt'
    persist_directory = 'gaia_chroma_db'

    try:
        # Check if database already exists for persistence
        if os.path.exists(persist_directory):
            print("Existing database found. Loading from disk...")
            vectordb, embedding = load_existing_database(persist_directory)
        else:
            print("Creating new database...")
            texts = load_and_process_documents(document_path)
            vectordb, embedding = create_vector_database(texts, persist_directory)
            vectordb.persist() # Note: deprecated in recent Chroma, but harmless

        qa = create_qa_chain(vectordb) # Initialize the QA chain

        queries = [
            "What did the president say about Ketanji Brown Jackson?",
            "What were the main economic points mentioned?",
            "What was said about international relations?"
        ]

        for query in queries:
            print(f"\nQuery: {query}")
            try:
                result = qa.invoke({"query": query})
                print(f"Answer: {result['result']}")
                if 'source_documents' in result:
                    print(f"\nSources used: {len(result['source_documents'])} documents")
                    for i, doc in enumerate(result['source_documents'][:2]):
                        print(f"Source {i+1}: {doc.page_content[:100]}...")
            except Exception as e:
                print(f"Error processing query: {e}")

        # Cleanup option
        # ... (code for deleting the database) ...

    except Exception as e:
        print(f"Error in main execution: {e}")
        print("Please check your Gaia Node configuration and ensure it's running")
او main عملکرد مرکز کنترل است:
- ابتدا بررسی می کند که نمونه Chromadb از قبل روی دیسک وجود دارد. اگر چنین است ، او آن را بار می کند ، و باعث صرفه جویی در وقت می شود. در غیر این صورت ، اسناد را بارگیری می کند ، تعبیه شده جدید ایجاد می کند و یک Chromadb جدید ایجاد می کند.
- سپس اولیه سازی کنید
RetrievalQAزنجیره ای با استفاده از پایگاه داده بردار ایجاد شده/بارگذاری شده. - این لیست توسط لیستی از درخواست های نمونه تکرار می شود و هر یک از آنها را ارسال می کند
qaزنجیر مهمترین چیز این است که ما از آن استفاده می کنیمqa.invoke({"query": query})در اینجاکه روش به روز شده و توصیه شده برای تماس با زنجیرهای Langchain است و به یک هشدار استهلاک پرداخته می شود. - سرانجام ، پاسخ و منابع اسناد مورد استفاده LLM را چاپ می کند و گزینه ای برای پاکسازی را فراهم می کند
gaia_chroma_dbدایرکتوری

Chromadb Deep Dive: فروشگاه بردار محلی شما
Chromadb چیست؟
Chroma یک پایگاه داده بردار منبع باز است که برای سادگی و عملکرد طراحی شده است ، به خصوص برای برنامه های کاربردی از جمله نصب مناسب است. در مورد این به عنوان یک بانک اطلاعاتی تخصصی “اثر انگشت عددی” (جاسازی) داده های خود فکر کنید. هنگامی که یک قطعه متن (یا تصویر ، صوتی و غیره) دارید ، یک مدل ساخته شده آن را به لیست طولانی اعداد (بردار) تبدیل می کند. Chroma این بردارها را به همراه داده های اصلی خود ذخیره می کند ، که به شما امکان می دهد به سرعت بردارهای دیگری را که در فضای عددی “مشابه” هستند پیدا کنید. این شباهت اغلب با شباهت معنایی در داده های اصلی ارتباط دارد.
ویژگی های اصلی این پروژه:
- پشتکار محلی: این یک ویژگی عالی برای توسعه است. هنگام استفاده
persist_directory='gaia_chroma_db'Chroma تمام ابرداده های ساخته شده و مرتبط را در پرونده های موجود در دیسک محلی شما ذخیره می کند. این بدان معنی است که پس از شروع روند تعبیه (که می تواند برای اسناد بزرگ مدت زمان زیادی طول بکشد) ، نیازی به انجام این کار دیگر نیست مگر اینکه اسناد شما تغییر کند. اجراهای زیر می تواند تقریباً بلافاصله پایگاه داده را بارگیری کند. - استفاده آسان: مشتری Python Chroma بسیار بصری است. ادغام با Langchain ساده است ، که فقط برای ایجاد ، شارژ و درخواست مجموعه های وکتور خود به چند خط کد نیاز دارد.
- کد باز و جامعه رانده شده: یک کد باز شفافیت ، انعطاف پذیری و جامعه رو به رشد برای پشتیبانی و مشارکت فراهم می کند.
- اجرای انعطاف پذیر: اگرچه برای استفاده موضعی “در فرآیند” قدرتمند است ، Chroma همچنین می تواند به عنوان یک سرور جداگانه انجام شود ، که در صورت افزایش نیازهای شما در خارج از یک نسخه از برنامه ، امکان اجرای در مقیاس بزرگتر را فراهم می کند.
چرا از Chromadb در اینجا استفاده می کنیم؟
برای این تظاهرات ، Chromadb یک انتخاب عالی است زیرا:
- این یک روش سریع و آسان برای شروع با پایگاه داده های بردار بدون نیاز به ایجاد زیرساخت های پیچیده ارائه می دهد.
- استقامت محلی آن به طور قابل توجهی تسریع می شود و از چندین فرآیند ساخته شده ساخته شده جلوگیری می کند.
- او یکپارچه با Langchain ادغام می شود
OpenAIEmbeddingsکه ما از گره Gaia شخصی خود تغذیه می کنیم. این یک قطعه خط لوله منسجم و مؤثر کاملاً تحت کنترل شما ایجاد می کند.
با ترکیب گره گایا برای یک LLM شخصی و ترکیب نتیجه گیری ، کرومادب برای ذخیره موثر محلی بردار و لانگچین برای یک ارکستراسیون بدون دردسر ، ما یک سیستم پارچه ای سالم و انعطاف پذیر ایجاد کردیم. این تنظیمات به توسعه دهندگان این امکان را می دهد تا با تمرکز بر یک تلاش توسعه هوش مصنوعی واقعاً محلی ، برنامه های هوشمند با کنترل بیشتر بر روی داده ها ، مدل ها و زیرساخت های خود ایجاد کنند.
این رویکرد برای:
- آزمایش با LLM های مختلف و مدل های تعبیه شده از سخت افزار خود.
- برنامه هایی که نیاز به حریم خصوصی داده دارند و نمی خواهند اطلاعات حساس را به API خارجی ارسال کنند.
- کاهش هزینه های API با مدیریت مدلهای محلی.
احساس راحتی کنید که این کد را تطبیق دهید ، در اسناد مختلف تغییر دهید ، یا با سایر LLM ها و مدل های جاسازی شده موجود در گره GAIA خود را آزمایش کنید.