عوامل هوش مصنوعی ساخته شده در بالای LLM از یک محدودیت عمده رنج می برند: آنها در لحظه پایان مکالمه همه چیز را فراموش می کنند. برای توسعه دهندگانی که سیستم های عامل حافظه TypeScript AI را می سازند، پاسخ معمولی شامل دستیابی به یک پایگاه داده برداری میزبان ابری است. اما برای استقرارهای تک عاملی، سناریوهای لبه و معماریهای درون محل، این وابستگی غیرضروری اضافی است. یک آموزش SQLite-vec Node.js که حافظه لایهای واقعی را پوشش میدهد، نه فقط جستجوی برداری، شکافی را پر میکند که اکثر آموزشها کاملاً نادیده میگیرند. این مقاله یک فروشگاه حافظه کامل و ماژولار TypeScript با پشتیبانی SQLite و sqlite-vec ایجاد میکند و سطوح اپیزودیک، معنایی و رویهای حافظه را در یک پایگاه داده محلی واحد با هیچ وابستگی به سرویسهای خارجی خارج از Node.js یکپارچه میکند.
چگونه با TypeScript و SQLite-vec یک عامل هوش مصنوعی حافظه لایه ای بسازیم
- مقداردهی اولیه یک پروژه TypeScript با وابستگی های بهتر sqlite3 و sqlite-vec، پیکربندی حالت سخت و ماژول های CommonJS.
- بارگذاری کنید پسوند زمان اجرا sqlite-vec در نمونه پایگاه داده بهتر sqlite3 خود و فعال کردن حالت WAL.
- تعریف کنید طرحواره لایهای با جداول اپیزودیک (فایل لاگ فقط افزودنی)، معنایی (فراداده + جدول مجازی vec0) و رویهای (قوانین ساختاریافته).
- اجرا کنند روشهای حافظه اپیزودیک برای ثبت خطوط تعامل و بازیابی قسمتهای فشردهنشده اخیر در هر جلسه.
- خرید کنید حافظههای معنایی با درج متادیتای محتوا و تعبیههای Float32Array در جدول مجازی vec0 با فاصله کسینوس.
- استعلام حافظه معنایی با استفاده از عملگر MATCH sqlite-vec برای استخراج ردیابی تعداد دسترسی نزدیکترین همسایه k برای خروج LRU.
- استخراج کنید قوانین رویه ای به عنوان زوج های ساختاریافته شرایط/عمل با امتیازات اطمینان و منشاء قسمت.
- تلفن هر سه سطح در یک حلقه عامل که زمینه را فراخوانی می کند، قوانین را اعمال می کند، پاسخ ها را تولید می کند و فشرده سازی اپیزودیک را آغاز می کند.
محتوا
چرا عوامل هوش مصنوعی به حافظه چند لایه نیاز دارند؟
مشکل مامور بی تابعیت
هر تماس برجسته LLM بدون تابعیت است. مدل یک اعلان دریافت می کند، یک پاسخ تولید می کند و هر حالت داخلی را کنار می گذارد. هنگامی که یک نماینده را در بالای تماسهای بدون حالت بدون لایه انعطافپذیری ایجاد میکنید، پیامدها به سرعت جمع میشوند: عامل خطاهایی را که کاربر قبلاً رفع کرده است، تکرار میکند و اطلاعات ارائهشده توسط کاربر را سه نوبت قبل درخواست میکند، اما نمیتواند رفتار خود را بر اساس تجربه تطبیق دهد. این یک مزاحم UX جزئی نیست. این اساساً سودمندی عامل را در هر سناریویی که مستلزم تداوم است، محدود میکند، خواه مدیریت وظایف چند جلسهای، کمک شخصی یا حل مشکل تکراری باشد. عامل در انزوا باهوش به نظر می رسد اما در طول زمان ناسازگار است.
اپیزودیک، معنایی و رویه ای: معماری شناختی
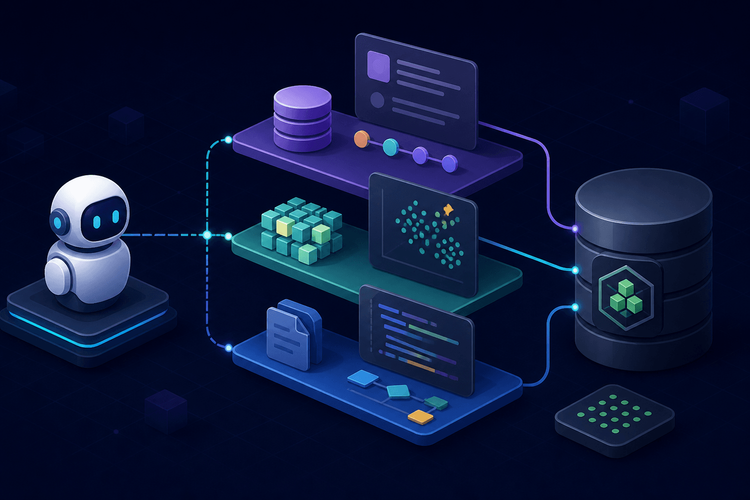
معماری حافظه عامل هوش مصنوعی سه لایه از علم شناختی با تقسیم حافظه به لایههای مجزا نشأت میگیرد:
- حافظه اپیزودیک آنچه اتفاق افتاده را ثبت میکند: گزارشهای تعامل با مهر زمانی، رکورد خام هر مبادله بین عامل و محیط آن، به تفکیک جلسه.
- حافظه معنایی آنچه را که عامل می داند تقطیر می کند. اینها حقایق، قطعات دانش و تعبیههای برداری آنها هستند که برای بازیابی بهجای تازگی بهینه شدهاند.
- به جای ذخیره متن آزاد، حافظه رویه ای قوانین عملیاتی، ترجیحات کاربر و الگوهای رفتاری را استخراج می کند که تصمیمات آینده را هدایت می کند.
اکثر آموزش های ذخیره سازی برداری در حافظه معنایی متوقف می شوند. اما عاملی که میتواند پایگاه دانش خود را جستجو کند اما نمیتواند آنچه در جلسه گذشته اتفاق افتاده (اپیزودیک) یا قوانینی را که یاد گرفته است (رویهای) به خاطر بیاورد، هنوز اساساً ناقص است. هر سه سطح برای یک عامل یادگیری واقعی ضروری هستند.
عاملی که می تواند پایگاه دانش خود را جستجو کند اما نمی تواند آنچه در جلسه گذشته اتفاق افتاده است (اپیزودیک) یا قوانینی را که یاد گرفته است (رویه ای) به خاطر بیاورد، هنوز اساساً ناقص است.
چرا SQLite و sqlite-vec برای حافظه عامل محلی؟
پایگاههای داده برداری ابری مانند Pinecone، Weaviate یا Chroma برای استقرار چند مستاجر و مقیاسپذیر منطقی هستند. برای استقرار یک عامل یا لبه، آنها تأخیر و هزینه شبکه را به اضافه پیچیدگی عملیاتی و وابستگی زمان اجرا خارجی معرفی می کنند. SQLite همه اینها را حذف می کند.
sqlite-vec یک افزونه SQLite است که قابلیت های جستجوی شباهت برداری را مستقیماً به SQLite اضافه می کند. جداول مجازی (با استفاده از vec0 ماژول) که بردارهای float32 را ذخیره می کند و پرس و جوهای k نزدیکترین همسایه را با توابع فاصله مانند کسینوس و L2 پشتیبانی می کند. فاصله کسینوس پیش فرض نیست. vec0 از فاصله L2 (اقلیدسی) استفاده می کند، مگر اینکه اعلان ستون به صراحت بیان کند distance_metric=cosine. sqlite-vec به عنوان یک پسوند زمان اجرا بارگذاری می شود، به فرآیند سرور جداگانه نیاز ندارد و با ابزارهای موجود SQLite کار می کند.
بهتر-sqlite3 اتصال SQLite ترجیحی برای Node.js در حلقه های عامل همزمان است. یک API همزمان (بدون تماس یا وعده در حلقههای محکم) ارائه میکند، از بارگیری برنامههای افزودنی از طریق پشتیبانی میکند. loadExtension()و پس از نصب نیاز به پیکربندی صفر دارد.
راه اندازی پروژه و وابستگی ها
پروژه TypeScript را راه اندازی کنید
این پروژه به Node.js 18.13+ نیاز دارد (الزامی برای node:test دونده describe/it صادرات بعدا استفاده می شود) و از TypeScript در حالت سختگیرانه استفاده می کند. سیستم ماژول انتخابی در اینجا CommonJS برای حداکثر سازگاری با اتصالات بومی sqlite3 بهتر است، اگرچه ESM با پیکربندی اضافی امکان پذیر است.
mkdir agent-memory && cd agent-memory
npm init -y
npm install better-sqlite3@11 sqlite-vec@0.1
npm install -D typescript @types/better-sqlite3 @types/node
npx tsc --init
توجه: نسخههای وابستگی را مطابق شکل بالا پین کنید (در حین استفاده با نسخههای پایدار فعلی جایگزین کنید). API پسوند sqlite-vec و sqlite3 بهتر loadExtension رفتار ممکن است در نسخه های اصلی تغییر کند.
تولید شده tsconfig.json باید برای این پروژه سفت شود:
{
  "compilerOptions": {
    "target": "ES2022",
    "module": "commonjs",
    "strict": true,
    "esModuleInterop": true,
    "outDir": "./dist",
    "rootDir": "./src",
    "declaration": true,
    "sourceMap": true,
    "resolveJsonModule": true
  },
  "include": ["src/**/*"]
}
اسکریپت های زیر را به package.json:
{
  "scripts": {
    "build": "tsc",
    "start": "node dist/agent-loop.js"
  }
}
برای کامپایل پروژه اجرا کنید npx tsc. برای اجرای هر فایل کامپایل شده، اجرا کنید node dist/. مثلاً بعد از خلقت src/db.ts زیر، کامپایل با npx tsc و بررسی کنید node dist/db.js. برای توسعه بدون مرحله کامپایل دستی، استفاده کنید npx tsx src/ (نصب کنید tsx به عنوان یک وابستگی توسعه دهنده اگر بخواهید).
بارگیری sqlite-vec به عنوان پسوند زمان اجرا
sqlite-vec باینری های از پیش ساخته شده را برای پلتفرم های اصلی (x64 Linux، x64/ARM64 macOS، x64 Windows) از طریق بسته npm خود توزیع می کند. را sqlite-vec صادرات ماژول npm a load() تابعی که نمونه بهتری از پایگاه داده sqlite3 می گیرد و پسوند کامپایل شده را برای پلتفرم فعلی بارگذاری می کند. در پلتفرمهای بدون باینریهای از پیش ساخته شده، یک ساخت از منبع مورد نیاز است که به کامپایلر C و هدرهای توسعه SQLite نیاز دارد.
import Database from "better-sqlite3";
import * as sqliteVec from "sqlite-vec";

export function createDatabase(dbPath: string): Database.Database {
  const db = new Database(dbPath);


  db.pragma("journal_mode = WAL");


  sqliteVec.load(db);


  const version = db.prepare("SELECT vec_version()").pluck().get() as string;
  console.log(`sqlite-vec version: ${version}`);

  return db;
}
را sqliteVec.load(db) فراخوانی داخلی مسیر توسعه را برای پلت فرم فعلی حل می کند. را vec_version() تابع اسکالار تأیید می کند که برنامه افزودنی فعال است و رشته نسخه آن را برمی گرداند، که به عنوان یک بررسی سریع عقلانی در طول اولیه سازی عمل می کند.
طراحی طرح چند لایه
جدول حافظه اپیزودیک
یک جدول تناوبی به عنوان یک گزارش فقط پیوست عمل می کند. هر ردیف نشاندهنده یک نوبت در یک مکالمه است که با شناسه جلسه تقسیم شده و مهر زمانی پشته مشخص شده است. الف token_count ستون از بازیابی بعدی با برچسبی پشتیبانی می کند که به عامل اجازه می دهد پنجره زمینه خود را بودجه بندی کند.
منطق طراحی: این جدول هرگز در جای خود به روز نمی شود. سطرها درج می شوند و در نهایت یا در حافظه معنایی فشرده می شوند یا بایگانی می شوند. شاخص های session_id و timestamp از دو مدل دسترسی اصلی پشتیبانی می کند: بازیابی حرکات اخیر در یک جلسه و انتخاب قسمت های قدیمی برای فشرده سازی.
جدول حافظه معنایی با ستون برداری
sqlite-vec از جداول مجازی استفاده می کند vec0 ماژول برای ذخیره و نمایه سازی بردارها. لایه حافظه معنایی یک جدول ساده حاوی ابرداده (متن محتوا، لینک قسمت منبع، ردیابی دسترسی) را با هم جفت می کند. vec0 جدول مجازی حاوی بردارهای تعبیه شده بعد جاسازی باید با بعد منبع مدل شما مطابقت داشته باشد: 384 ابعاد برای all-MiniLM-L6-v2 (همانطور که در نقشه مدل مشخص شده است)، 1536 برای OpenAI text-embedding-3-small (اندازه خروجی پیش فرض؛ این مدل از اندازه های خروجی متغیر پشتیبانی می کند) و غیره. شما بعد جاسازی را در حین ایجاد جدول تصحیح می کنید و برای تغییر آن باید جدول را دوباره ایجاد کنید.
جدول حافظه رویه ای
حافظه رویهای قوانین ساختاریافته را با امتیاز اطمینان بین 0 تا 1 ذخیره میکند. هر قانون به قسمتهای منبعی که آن را از طریق آرایه JSON از شناسههای قسمت تولید کرده است، مرتبط میشود. الف last_applied برچسب زمان به سبک LRU اجازه می دهد قوانین منسوخ را حذف کند.
چرا به جای متن آزاد، فیلدهایی برای شرایط/عملها ساختار یافته است؟ میتوان آنها را بهجای تکیه بر LLM برای تفسیر صحیح هر بار تجزیه و پیادهسازی کرد و رفتار عامل را قابل پیشبینیتر کرد.
import Database from "better-sqlite3";

export function initializeSchema(
  db: Database.Database,
  embeddingDimension: number = 384
): void {

  if (
    !Number.isInteger(embeddingDimension) ||
    embeddingDimension  1 ||
    embeddingDimension > 65536
  ) {
    throw new RangeError(
      `Invalid embeddingDimension: ${embeddingDimension}. Must be a positive integer ≤ 65536.`
    );
  }

  const dim = embeddingDimension;


  const initAll = db.transaction(() => {
    db.exec(`
      -- Episodic memory: append-only interaction log
      CREATE TABLE IF NOT EXISTS episodic_memory (
        id INTEGER PRIMARY KEY AUTOINCREMENT,
        session_id TEXT NOT NULL,
        role TEXT NOT NULL CHECK(role IN ('user', 'assistant', 'system')),
        content TEXT NOT NULL,
        timestamp TEXT NOT NULL DEFAULT (datetime('now')),
        token_count INTEGER NOT NULL DEFAULT 0,
        compacted INTEGER NOT NULL DEFAULT 0
      );
    `);

    db.exec(`
      CREATE INDEX IF NOT EXISTS idx_episodic_session
        ON episodic_memory(session_id, timestamp);
    `);

    db.exec(`
      CREATE INDEX IF NOT EXISTS idx_episodic_timestamp
        ON episodic_memory(timestamp);
    `);

    db.exec(`
      -- Semantic memory: metadata table
      CREATE TABLE IF NOT EXISTS semantic_memory (
        id INTEGER PRIMARY KEY AUTOINCREMENT,
        content TEXT NOT NULL,
        source_episode_id INTEGER,
        created_at TEXT NOT NULL DEFAULT (datetime('now')),
        access_count INTEGER NOT NULL DEFAULT 0,
        FOREIGN KEY (source_episode_id) REFERENCES episodic_memory(id)
      );
    `);

    db.exec(`
      -- Semantic memory: vector store (sqlite-vec virtual table)
      -- cosine distance is explicit via column declaration; L2 is the vec0 default
      CREATE VIRTUAL TABLE IF NOT EXISTS semantic_memory_vec USING vec0(
        id INTEGER PRIMARY KEY,
        embedding float[${dim}] distance_metric=cosine
      );
    `);

    db.exec(`
      -- Procedural memory: extracted rules and preferences
      CREATE TABLE IF NOT EXISTS procedural_memory (
        id INTEGER PRIMARY KEY AUTOINCREMENT,
        rule_condition TEXT NOT NULL,
        rule_action TEXT NOT NULL,
        confidence REAL NOT NULL DEFAULT 0.5 CHECK(confidence >= 0 AND confidence         source_episode_ids TEXT NOT NULL DEFAULT '[]',
        created_at TEXT NOT NULL DEFAULT (datetime('now')),
        last_applied TEXT
      );
    `);

    db.exec(`
      CREATE INDEX IF NOT EXISTS idx_procedural_confidence
        ON procedural_memory(confidence);
    `);
  });

  initAll();
}
توجه کنید vec0 اعلان جدول مجازی: بعد جاسازی به عنوان یک عدد صحیح مثبت مطمئن قبل از درونیابی در DDL و distance_metric=cosine به صراحت مشخص شده است (به طور پیش فرض vec0 L2/Euclidean است). را semantic_memory_vec جداول id ستون باید به صورت دستی با آن همگام شود semantic_memory.id زیرا جداول مجازی از کلیدهای خارجی پشتیبانی نمی کنند. را storeSemantic() روش زیر برای جلوگیری از یتیم شدن ردیفها، هر دو درج را در یک تراکنش قرار میدهد. تمام DDL در یک تراکنش پیچیده شده است، بنابراین اگر هر عبارتی شکست بخورد (مثلاً CREATE VIRTUAL TABLE شکست می خورد زیرا sqlite-vec بارگیری نمی شود)، هیچ یک از جدول ها متعهد نمی شوند، که از یک طرح جزئی جلوگیری می کند.
ساخت ماژول ذخیره سازی حافظه
این بخش کل را می سازد agent-memory-store.ts ماژول به تدریج هر روش به سطح خاصی از معماری حافظه می پردازد.
رابط کلاس AgentMemoryStore
API عمومی هفت روش را نشان می دهد که سه سطح حافظه به اضافه یک عملیات فشرده سازی را پوشش می دهد. سازنده یک مسیر فایل پایگاه داده، یک بعد جاسازی و یک سن فشرده سازی پیش فرض در دقیقه را می پذیرد که به عنوان مقدار پیش فرض برای maxAgeMinutes پارامتر از compactEpisodes().
import Database, { Statement } from "better-sqlite3";
import { createDatabase } from "./db";
import { initializeSchema } from "./schema";

export interface EpisodicRecord {
  id: number;
  session_id: string;
  role: "user" | "assistant" | "system";
  content: string;
  timestamp: string;
  token_count: number;
}

export interface SemanticRecord {
  id: number;
  content: string;
  distance: number;
  access_count: number;
}

export interface ProceduralRecord {
  id: number;
  rule_condition: string;
  rule_action: string;
  confidence: number;
  source_episode_ids: number[];
  last_applied: string | null;
}


function float32ToBuffer(arr: Float32Array): Buffer {
  return Buffer.from(arr.buffer, arr.byteOffset, arr.byteLength);
}

export class AgentMemoryStore {
  private db: Database.Database;
  private embeddingDimension: number;
  private compactionThreshold: number;


  private stmtLogEpisode: Statement;
  private stmtGetRecentEpisodes: Statement;
  private stmtInsertSemanticMeta: Statement;
  private stmtInsertSemanticVec: Statement;
  private stmtRecallSemantic: Statement;
  private stmtUpdateAccessCount: Statement;
  private stmtStoreRule: Statement;
  private stmtGetRules: Statement;
  private stmtSelectCompact: Statement;
  private stmtMarkCompacted: Statement;

  constructor(
    dbPath: string = "agent-memory.db",
    embeddingDimension: number = 384,
    compactionThreshold: number = 1440
  ) {
    this.embeddingDimension = embeddingDimension;
    this.compactionThreshold = compactionThreshold;
    this.db = createDatabase(dbPath);

    try {
      initializeSchema(this.db, embeddingDimension);


      this.stmtLogEpisode = this.db.prepare(`
        INSERT INTO episodic_memory (session_id, role, content, token_count)
        VALUES (?, ?, ?, ?)
      `);

      this.stmtGetRecentEpisodes = this.db.prepare(`
        SELECT id, session_id, role, content, timestamp, token_count
        FROM episodic_memory
        WHERE session_id = ? AND compacted = 0
        ORDER BY timestamp DESC
        LIMIT ?
      `);

      this.stmtInsertSemanticMeta = this.db.prepare(`
        INSERT INTO semantic_memory (content, source_episode_id)
        VALUES (?, ?)
      `);

      this.stmtInsertSemanticVec = this.db.prepare(`
        INSERT INTO semantic_memory_vec (id, embedding)
        VALUES (?, ?)
      `);

      this.stmtRecallSemantic = this.db.prepare(`
        SELECT
          v.id,
          sm.content,
          v.distance,
          sm.access_count
        FROM semantic_memory_vec v
        INNER JOIN semantic_memory sm ON sm.id = v.id
        WHERE v.embedding MATCH ?
          AND k = ?
        ORDER BY v.distance
        LIMIT ?
      `);

      this.stmtUpdateAccessCount = this.db.prepare(`
        UPDATE semantic_memory SET access_count = access_count + 1 WHERE id = ?
      `);

      this.stmtStoreRule = this.db.prepare(`
        INSERT INTO procedural_memory (rule_condition, rule_action, confidence, source_episode_ids)
        VALUES (?, ?, ?, ?)
      `);

      this.stmtGetRules = this.db.prepare(`
        SELECT id, rule_condition, rule_action, confidence, source_episode_ids, last_applied
        FROM procedural_memory
        WHERE confidence >= ?
        ORDER BY confidence DESC
      `);

      this.stmtSelectCompact = this.db.prepare(`
        SELECT id, session_id, role, content, timestamp, token_count
        FROM episodic_memory
        WHERE compacted = 0
          AND timestamp         ORDER BY timestamp ASC
      `);

      this.stmtMarkCompacted = this.db.prepare(`
        UPDATE episodic_memory SET compacted = 1 WHERE id = ?
      `);
    } catch (err) {
      this.db.close();
      throw err;
    }
  }
ضبط در حافظه اپیزودیک
هر نوبت تعامل به عنوان نوبت اضافه می شود. عبارات آماده شده یک بار در سازنده کامپایل می شوند و مجدداً در فراخوانی استفاده می شوند، که در چرخه های محدود عامل که در آن چندین حرکت در ثانیه ثبت می شود، مهم است.
  logEpisode(
    sessionId: string,
    role: "user" | "assistant" | "system",
    content: string,
    tokenCount: number = 0
  ): number {
    const result = this.stmtLogEpisode.run(sessionId, role, content, tokenCount);
    return Number(result.lastInsertRowid);
  }

  getRecentEpisodes(sessionId: string, limit: number = 20): EpisodicRecord[] {
    return this.stmtGetRecentEpisodes.all(sessionId, limit) as EpisodicRecord[];
  }
را compacted flag قسمت هایی را که قبلاً در حافظه معنایی خلاصه شده اند فیلتر می کند و از شمارش مضاعف عامل از بافت قدیمی جلوگیری می کند.
ذخیره سازی و بازیابی حافظه معنایی با sqlite-vec
این فنی ترین بخش ماژول است. توکارها باید به صورت بافرهای خام بایت (Float32Array تبدیل به بافر) برای درج در آنها سریال شوند. vec0 میز مجازی استخراج از دستور k-نزدیکترین همسایه sqlite-vec با استفاده می کند MATCH اپراتور و الف k پارامتر برای گزارش تعداد همسایگان به زمانبندی پرس و جو vec0 به اضافه a LIMIT برای محدود کردن نتایج
  storeSemantic(
    content: string,
    embedding: Float32Array,
    sourceEpisodeId?: number
  ): number {

    const insertBoth = this.db.transaction(
      (content: string, sourceEpisodeId: number | null, embeddingBuffer: Buffer) => {

        const metaResult = this.stmtInsertSemanticMeta.run(content, sourceEpisodeId);
        const id = Number(metaResult.lastInsertRowid);


        this.stmtInsertSemanticVec.run(id, embeddingBuffer);

        return id;
      }
    );


    const embeddingBuffer = float32ToBuffer(embedding);
    return insertBoth(content, sourceEpisodeId ?? null, embeddingBuffer);
  }

  recallSemantic(
    queryEmbedding: Float32Array,
    topK: number = 5
  ): SemanticRecord[] {

    const queryBuffer = float32ToBuffer(queryEmbedding);


    const results = this.stmtRecallSemantic.all(
      queryBuffer,
      topK,
      topK
    ) as SemanticRecord[];


    if (results.length > 0) {
      const updateMany = this.db.transaction((ids: number[]) => {
        for (const id of ids) this.stmtUpdateAccessCount.run(id);
      });
      updateMany(results.map((r) => r.id));
    }

    return results;
  }
جزئیات کلیدی در این اجرا: MATCH عملگر در ستون جدول مجازی یک جستجوی برداری sqlite-vec را راه اندازی می کند. را k پارامتر ج WHERE بند تعداد همسایگان مورد نظر را به زمانبندی پرس و جو vec0 و مخابره می کند LIMIT بند مجموعه نتایج نهایی را محدود می کند. مقدار فاصله در نتایج از توان مشخص شده در اعلان ستون استفاده می کند (اگر به صورت بالا اعلام شود کسینوس). مقادیر پایین تر نشان دهنده شباهت بیشتر است.
محدودیت بحرانی هم ترازی ابعاد است: بعد منبع مدل تعبیه شده باید دقیقاً با بعد مشخص شده هنگام ایجاد جدول مجازی vec0 مطابقت داشته باشد.
بازیابی و ذخیره قوانین رویه ای
قوانین به جای متن آزاد از یک قالب شرط/عمل ساختاریافته استفاده می کنند. را source_episode_ids فیلد یک آرایه سریالسازی شده با JSON را ذخیره میکند که هر قانون را به تعاملات اپیزودیکی که آن را ایجاد کردهاند مرتبط میکند و منشأ را حفظ میکند.
  storeRule(
    condition: string,
    action: string,
    confidence: number,
    sourceEpisodeIds: number[] = []
  ): number {
    const result = this.stmtStoreRule.run(
      condition,
      action,
      confidence,
      JSON.stringify(sourceEpisodeIds)
    );
    return Number(result.lastInsertRowid);
  }

  getApplicableRules(minConfidence: number = 0.7): ProceduralRecord[] {
    const rows = this.stmtGetRules.all(minConfidence) as any[];
    return rows.map((row) => ({
      ...row,
      source_episode_ids: JSON.parse(row.source_episode_ids),
    }));
  }
فشرده سازی اپیزودیک لاگ خودکار
لاگ های اپیزودیک نامحدود هم عملکرد پرس و جو و هم بودجه پنجره زمینه را کاهش می دهند. استراتژی فشردهسازی قسمتهای قدیمیتر از آستانه قابل تنظیم را انتخاب میکند، آنها را فشرده علامتگذاری میکند، و محتوای آنها را برای خلاصهسازی خارجی برمیگرداند. تماس گیرنده تماس جمع آوری LLM را مدیریت می کند و این ماژول را LLM-agnostic نگه می دارد.
  compactEpisodes(maxAgeMinutes?: number): EpisodicRecord[] {

    const ageMinutes =
      maxAgeMinutes !== undefined ? maxAgeMinutes : this.compactionThreshold;

    if (!Number.isFinite(ageMinutes) || ageMinutes  0) {
      throw new RangeError(
        `maxAgeMinutes must be a non-negative finite number, got: ${ageMinutes}`
      );
    }


    const compact = this.db.transaction((age: number) => {
      const episodes = this.stmtSelectCompact.all(age) as EpisodicRecord[];

      for (const episode of episodes) {
        this.stmtMarkCompacted.run(episode.id);
      }

      return episodes;
    });

    return compact(ageMinutes);
  }

  close(): void {
    this.db.close();
  }
}
یک لفاف تراکنش تضمین می کند که یا تمام قسمت های انتخاب شده فشرده علامت گذاری شده اند یا هیچ کدام نیستند، و از فشرده سازی جزئی در هنگام شکست جلوگیری می کند. تماسگیرنده محتوای اپیزود خام را دریافت میکند، گروهبندی میکند یا آن را خلاصه میکند (از طریق تماس LLM)، و نتیجه را با استفاده از آن در حافظه معنایی ذخیره میکند. storeSemantic().
اتصال حافظه به زنجیره عامل
حداقل چرخه عامل با واکشی حافظه
چرخه عامل از یک توالی متوالی پیروی می کند: دریافت ورودی، فراخوانی زمینه معنایی مناسب، بررسی قوانین رویه ای، ایجاد پاسخ، ثبت قسمت، و ایجاد فشرده سازی مشروط. حافظه های بازیابی شده به عنوان متن ساختاریافته به بخش سیستم یا زمینه اعلان LLM تزریق می شوند.
import { AgentMemoryStore } from "./agent-memory-store";


async function generateResponse(
  systemContext: string,
  userMessage: string
): Promisestring> {
  return `Response to: ${userMessage}`;
}


async function getEmbedding(text: string): PromiseFloat32Array> {

  return new Float32Array(384);
}

export async function agentStep(
  store: AgentMemoryStore,
  sessionId: string,
  userMessage: string
): Promisestring> {

  const userEpisodeId = store.logEpisode(sessionId, "user", userMessage);


  const queryEmbedding = await getEmbedding(userMessage);
  const relevantMemories = store.recallSemantic(queryEmbedding, 5);


  const rules = store.getApplicableRules(0.7);


  const memoryContext = relevantMemories
    .map((m) => `[Memory] ${m.content}`)
    .join("
");
  const ruleContext = rules
    .map((r) => `[Rule] IF ${r.rule_condition} THEN ${r.rule_action}`)
    .join("
");
  const recentEpisodes = store
    .getRecentEpisodes(sessionId, 10)
    .slice()
    .reverse()
    .map((e) => `${e.role}: ${e.content}`)
    .join("
");

  const systemContext = [memoryContext, ruleContext, recentEpisodes]
    .filter(Boolean)
    .join("

");


  const response = await generateResponse(systemContext, userMessage);


  store.logEpisode(sessionId, "assistant", response);

  return response;
}
تعبیه استراتژی تولید
را getEmbedding() تابع بالا یک خرد آگاهانه است که بردار تهی را برمی گرداند. برای قوام محلی، @huggingface/transformers بسته (بسته رسمی Hugging Face npm) استنتاج مبتنی بر ONNX را ارائه می دهد که به طور کامل در Node.js بدون فراخوانی API اجرا می شود. مدل هایی مانند all-MiniLM-L6-v2 تعبیههای 384 بعدی با وزنهای ONNX تقریباً 80 مگابایتی ایجاد میکند که آنها را برای پینهای CPU غیر GPU کاربردی میکند. گزینههای مبتنی بر API از OpenAI یا Cohere کار میکنند، اما یک وابستگی شبکه را دوباره معرفی میکنند که با طراحی اولیه محلی در تضاد است.
محدودیت بحرانی تراز ابعادی است: بعد خروجی مدل تعبیه شده باید دقیقاً با بعد مشخص شده در هنگام ایجاد مطابقت داشته باشد. vec0 میز مجازی عدم تطابق منجر به خطاهای درج یا نتایج جستجوی خراب می شود.
export type EmbeddingFunction = (text: string) => PromiseFloat32Array>;


export const getEmbedding: EmbeddingFunction = async (
  text: string
): PromiseFloat32Array> => {


  throw new Error("Embedding function not implemented — replace this stub with a real embedding provider");
};
ملاحظات عملکرد و بهینه سازی
عملکرد نمایه سازی و پرس و جو
این طرح اکنون شامل شاخص هایی از session_id، timestamp، و confidenceپوشش الگوهای پرس و جو اولیه جستجوی برداری sqlite-vec به صورت پیشفرض از طریق اسکن خطی دقیق k-NN است، نه تقریبی. این بدان معنی است که زمان پرس و جو با تعداد بردارهای ذخیره شده به صورت خطی مقیاس می شود. در لپتاپهای 2020، درخواستهای مربوط به 10000 بردار در میلیثانیه تک رقمی کامل میشوند، اما باید با سختافزار هدف خود مقایسه کنید. فراتر از این مقیاس، تأخیر پرس و جو به صورت خطی با تعداد بردارها افزایش می یابد و جایگزین هایی مانند شاخص های تقریبی نزدیکترین همسایه یا استراتژی های پارتیشن بندی ضروری می شوند.
را createDatabase() ویژگی حالت WAL (Write-Ahead Logging) را فعال میکند، که توان نوشتن را بهبود میبخشد و امکان خواندن همزمان سایر فرآیندها را در حین انجام نوشتن فراهم میکند. این در معماری عامل مهم است که در آن یک فرآیند جداگانه (مانند یک مانیتور یا یک نمونه عامل دوم) پایگاه داده را در حین نوشتن فرآیند اصلی می خواند، یا جایی که فشرده سازی پس زمینه در کنار سرویس پرس و جو فعال کار می کند.
مدیریت بودجه حافظه
دو استراتژی از رشد نامحدود فروشگاه معنایی جلوگیری می کند. اول، اخراج LRU از access_count: حذف یا بایگانی رکوردهای معنایی با تعداد دسترسی صفر یا کم قدیمی تر از آستانه TTL بر اساس created_at (یک نقطه شروع معقول 30 روز با access_count = 0). دوم، واکشی با توکن: token_count ستون برای رکوردهای اپیزودیک و طول محتوای رکوردهای معنایی به حلقه عامل اجازه می دهد تا به جای بازیابی کورکورانه یک top-k ثابت، زمینه را تا حداکثر بودجه توکن جمع کند.
تست فروشگاه حافظه
تست واحد با SQLite در حافظه
عبور از آن سوی :memory: به عنوان مسیر پایگاه داده AgentMemoryStore یک پایگاه داده کاملاً ایزوله در حافظه ایجاد می کند که پس از هر آزمایش تخلیه می شود. این باعث می شود آزمایش ها سریع و بدون عوارض جانبی انجام شوند. را node:test دونده با describe/it به Node.js 18.13 یا جدیدتر نیاز دارد.
import { describe, it, beforeEach, afterEach } from "node:test";
import assert from "node:assert/strict";
import { AgentMemoryStore } from "./agent-memory-store";

describe("AgentMemoryStore", () => {
  let store: AgentMemoryStore;

  beforeEach(() => {
    store = new AgentMemoryStore(":memory:", 3);
  });

  afterEach(() => {

    store.close();
  });

  it("logEpisode returns a positive integer ID", () => {
    const id = store.logEpisode("s1", "user", "hello");
    assert.ok(typeof id === "number" && id > 0);
  });

  it("getRecentEpisodes returns only non-compacted rows for the session", () => {
    store.logEpisode("s1", "user", "msg1");
    store.logEpisode("s2", "user", "other-session");
    const episodes = store.getRecentEpisodes("s1", 10);
    assert.strictEqual(episodes.length, 1);
    assert.strictEqual(episodes[0].content, "msg1");
  });

  it("returns nearest neighbor correctly by cosine distance", () => {

    const embeddingA = new Float32Array([1.0, 0.0, 0.0]);
    const embeddingB = new Float32Array([0.0, 1.0, 0.0]);
    const query = new Float32Array([0.9, 0.1, 0.0]);

    store.storeSemantic("Fact about TypeScript", embeddingA);
    store.storeSemantic("Fact about Python", embeddingB);

    const results = store.recallSemantic(query, 2);

    assert.strictEqual(results.length, 2);
    assert.strictEqual(results[0].content, "Fact about TypeScript");
    assert.ok(results[0].distance  results[1].distance);
  });

  it("recallSemantic increments access_count on retrieved records", () => {
    const emb = new Float32Array([1.0, 0.0, 0.0]);
    store.storeSemantic("tracked fact", emb);
    store.recallSemantic(new Float32Array([1.0, 0.0, 0.0]), 1);
    const results = store.recallSemantic(new Float32Array([1.0, 0.0, 0.0]), 1);
    assert.strictEqual(results[0].access_count, 2);
  });

  it("recallSemantic on empty store returns empty array without throwing", () => {
    const results = store.recallSemantic(new Float32Array([1.0, 0.0, 0.0]), 5);
    assert.deepStrictEqual(results, []);
  });

  it("compactEpisodes with no argument uses compactionThreshold default", () => {
    const store2 = new AgentMemoryStore(":memory:", 3, 0);
    store2.logEpisode("s1", "user", "old message");
    const compacted = store2.compactEpisodes();
    assert.ok(Array.isArray(compacted));
    store2.close();
  });

  it("getApplicableRules filters by minConfidence and parses JSON", () => {
    store.storeRule("user is rude", "respond calmly", 0.9, [1, 2]);
    store.storeRule("user is happy", "match energy", 0.3, []);
    const rules = store.getApplicableRules(0.7);
    assert.strictEqual(rules.length, 1);
    assert.deepStrictEqual(rules[0].source_episode_ids, [1, 2]);
  });

  it("initializeSchema rejects non-integer embeddingDimension", () => {
    assert.throws(
      () => new AgentMemoryStore(":memory:", 3.5),
      /Invalid embeddingDimension/
    );
  });
});
استفاده از فضای تعبیه سه بعدی در تست ها، داده های آزمون را برای استدلال در مورد آن بی اهمیت نگه می دارد، در حالی که هنوز مسیر جستجوی کامل sqlite-vec را انجام می دهید. ادعاها برای ترتیب صحیح، فاصله نسبی، ردیابی تعداد ضربه، و اعتبارسنجی ورودی، گرفتن رگرسیون در خط لوله جستجوی برداری بررسی میکنند.
برای اجرای تست ها بعد از ساخت: node --test dist/agent-memory-store.test.js
از اینجا کجا برویم؟
گسترش معماری
سطحی از حافظه کاری که در این فرآیند به عنوان یک نقشه یا آرایه ساده نگهداری می شود و هرگز ذخیره نمی شود، می تواند اسکرچ پد عامل را برای کار فعلی مدل کند. این حالت استدلال کوتاه مدت را از حافظه بلند مدت بدون ورودی های اضافی پایگاه داده جدا می کند.
برای سناریوهای چند عاملی، ابزارهای تکرار SQLite مانند Litestream (پشتیبان گیری مداوم جریان به فضای ذخیره سازی سازگار با S3) یا LiteFS (SQLite توزیع شده از طریق FUSE؛ به یک محیط لینوکس سازگار با FUSE نیاز دارد و از macOS یا Windows پشتیبانی نمی کند) به اشتراک گذاری حافظه بین نمایندگان را بدون رها کردن SQLite زیربنایی فعال می کند.
وقتی ذخیره معنایی تضادها یا سوابق اضافی را جمع می کند چه اتفاقی می افتد؟ حلقههای انعکاس این کار را انجام میدهند: یک فرآیند پسزمینه به طور دورهای ذخیره معنایی را اسکن میکند، تضادها را شناسایی میکند، سوابق را یکپارچه میکند، و امتیازات اطمینان قواعد رویهای را تنظیم میکند. معماری سه لایه این امکان را فراهم می کند زیرا عامل می تواند حافظه خود را در همه سطوح جستجو، مقایسه و بازنویسی کند.
معماری سه لایه این امکان را فراهم می کند زیرا عامل می تواند حافظه خود را در همه سطوح جستجو، مقایسه و بازنویسی کند.
سخت شدن تولید
رمزگذاری داده های اپیزودیک حساس (پیام های کاربر، اطلاعات شخصی) در حالت استراحت. یک فورک از جامعه sqlcipher رمزگذاری شفاف منبع باز را فراهم می کند. SEE’s SQLite (SQLite Encryption Extension) یک جایگزین است، اما به مجوز تجاری پولی از کنسرسیوم SQLite نیاز دارد. توجه داشته باشید که حالت WAL ایجاد می کند .db-wal و .db-shm فایل ها به همراه پایگاه داده اصلی؛ مطمئن شوید که رمزگذاری هر سه فایل را پوشش می دهد.
انتقال طرحواره نسخه با یک عدد صحیح ساده ذخیره شده در SQLite user_version پراگما هنگام راهاندازی با توابع مهاجرت بهطور متوالی بررسی شد. نظارت باید تعداد ردیفهای جدول، تعداد بردارهای ذخیره معنایی، نرخ فشردهسازی و متوسط تأخیر پرسوجو را ردیابی کند تا رشد کنترلنشده یا کاهش عملکرد پرسوجو را قبل از تأثیرگذاری بر رفتار عامل تشخیص دهد.
Source link