مدلهای زبان بزرگ میتوانند بازخورد مشتری را خلاصه کنند، درخواستهای پشتیبانی را طبقهبندی کنند و الگوها را در دادههای عملیاتی توضیح دهند. با این حال، ارسال ردیف های خام از یک پایگاه داده به طور مستقیم به یک مدل، مسائل امنیتی، دقت و هزینه را ایجاد می کند.
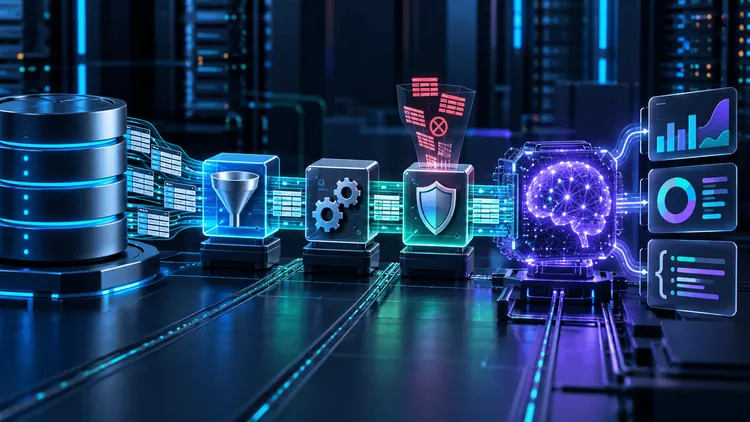
یک معماری امن تر این است که فقط رکوردهای PostgreSQL لازم را استخراج کنید، آنها را به یک مجموعه داده تحلیلی کوچک تبدیل کنید و این مجموعه داده کنترل شده را به LLM منتقل کنید. این آموزش این گردش کار را با Node.js می سازد.
این مثال درخواستهای پشتیبانی را تجزیه و تحلیل میکند، اما همین مدل را میتوان برای بررسی محصول، پاسخهای نظرسنجی، گزارشهای رویداد و یادداشتهای فروش تطبیق داد.
چرا یک لایه ETL مورد نیاز است
ETL مخفف Extract, Transform and Load است. خطوط لوله سنتی داده های تبدیل شده را به یک انبار یا پایگاه داده گزارش بارگذاری می کنند. در یک برنامه LLM، مقصد نهایی ممکن است یک تابع تحلیل کنترل شده باشد.
استفاده از لایه ETL چندین مزیت دارد:
- مدل فقط فیلدهای مرتبط را دریافت می کند.
- مقادیر حساس ممکن است قبل از انتقال حذف شوند.
- PostgreSQL محاسباتی را انجام می دهد که به LLM نیاز ندارند.
- اعلان یک اندازه قابل پیش بینی باقی می ماند.
- برنامه میتواند خروجی مدل را قبل از ذخیره آن تأیید کند.
هنگام ارزیابی راه حل های PostgreSQL ETL، توسعه دهندگان باید بیش از جابجایی خطوط بین سیستم ها را در نظر بگیرند. خط لوله همچنین باید مشخص کند که چه اطلاعاتی می توانند از پایگاه داده خارج شوند، چگونه رکوردها گروه بندی می شوند و آیا هر تبدیل قابل تکرار است یا خیر.
LLM باید داده های آماده شده را تفسیر کند. نباید به یک رابط نامحدود برای پایگاه داده تولید تبدیل شود.
جدول بلیط پشتیبانی را ایجاد کنید
فرض کنید که برنامه درخواست های پشتیبانی را در این جدول ذخیره می کند:
CREATE TABLE support_tickets (
  id BIGSERIAL PRIMARY KEY,
  category TEXT NOT NULL,
  message TEXT NOT NULL,
  priority TEXT NOT NULL,
  customer_email TEXT,
  created_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),
  analyzed_at TIMESTAMPTZ
);
درج چند نمونه رکورد:
INSERT INTO support_tickets
  (category, message, priority, customer_email)
VALUES
  (
    'billing',
    'My card was charged twice for the same subscription.',
    'high',
    'customer@example.com'
  ),
  (
    'account',
    'The password reset email has not arrived.',
    'medium',
    'another@example.com'
  ),
  (
    'billing',
    'I cannot download the latest invoice.',
    'low',
    'buyer@example.com'
  );
را customer_email این زمینه برای سیستم نگهداری مفید است، اما برای تجزیه و تحلیل روند ضروری نیست. بنابراین، درخواست واکشی باید آن را خاموش کند.
این امن تر از استخراج هر ستون و امید به حذف اطلاعات حساس در آینده است.
پروژه Node.js را راه اندازی کنید
یک پروژه ایجاد کنید و درایور PostgreSQL را نصب کنید:
mkdir postgres-llm-pipeline
cd postgres-llm-pipeline
npm init -y
npm install pg dotenv
اضافه کنید "type": "module" به package.json بنابراین نمونه ها می توانند از ماژول های ES استفاده کنند.
ایجاد یک .env فایل:
DATABASE_URL=postgres://app:password@localhost:5432/support
LLM_API_URL=https://example-llm-provider.test/v1/analyze
LLM_API_KEY=replace-with-a-development-key
این فایل را خارج از کنترل نسخه نگه دارید:
.env
URL LLM در این مثال عمداً فروشنده خنثی است. آن را با نقطه پایانی مستند و فرمت احراز هویت سرویس مدلی که استفاده می کنید جایگزین کنید.
ایجاد کنید pipeline.js و اتصال پایگاه داده را پیکربندی کنید:
import "dotenv/config";
import pg from "pg";

const { Pool } = pg;

const pool = new Pool({
  connectionString: process.env.DATABASE_URL,
  max: 5,
  idleTimeoutMillis: 10_000
});
سپس مجموعه محدودی از بلیط های تجزیه و تحلیل نشده را بازیابی کنید:
async function extractTickets(limit = 100) {
  const result = await pool.query(
    `
      SELECT id, category, message, priority, created_at
      FROM support_tickets
      WHERE analyzed_at IS NULL
      ORDER BY created_at ASC
      LIMIT $1
    `,
    [limit]
  );

  return result.rows;
}
این محدودیت مانع از قرار دادن تصادفی هزاران رکورد در یک خط لوله می شود. کوئری های پارامتری شده نیز مقادیر را از عبارات SQL جدا نگه می دارند.
برای انتقال های بسیار بزرگ، PostgreSQL فراهم می کند COPY دستوری که می تواند داده ها را به طور موثر بین جداول و فایل ها جابجا کند. خط لوله تعاملی LLM معمولاً از دستههای کوچکتر سود میبرد زیرا تکرار، تأیید و اعتبارسنجی آسانتر است.
تبدیل رکوردها
مرحله تبدیل باید جزئیات غیر ضروری را حذف کند و مقدار متن ارسال شده برای تجزیه و تحلیل را محدود کند.
function normalizeText(value, maxLength = 500) {
  return value
    .replace(/\s+/g, " ")
    .trim()
    .slice(0, maxLength);
}

function transformTickets(rows) {
  return rows.map(row => ({
    id: String(row.id),
    category: row.category,
    priority: row.priority,
    message: normalizeText(row.message),
    createdAt: row.created_at.toISOString()
  }));
}
این تبدیل چهار عملیات مفید را انجام می دهد:
- آدرس های ایمیل مشتری را شامل نمی شود.
- شناسه های پایگاه داده را به رشته تبدیل می کند.
- فضای سفید غیر ضروری را عادی می کند.
- طول هر پیام را محدود می کند.
محدودیت های طول از بافت مدل محافظت می کنند، اما باید با دقت انتخاب شوند. کوتاه کردن تهاجمی می تواند بخشی از پیام را که مشکل واقعی را توضیح می دهد حذف کند.
سیستم تولید همچنین ممکن است نیاز به شناسایی شماره تلفن، شناسه حساب، آدرس یا اطلاعات پرداخت داشته باشد. قوانین ویرایش باید جدا از اعلان آزمایش شوند.
اجازه دهید PostgreSQL تجزیه و تحلیل قطعی انجام دهد
LLM برای شمارش دستهها یا محاسبه مجموع لازم نیست. PostgreSQL می تواند این مقادیر را سریعتر و قابل پیش بینی تر تولید کند.
function summarizeTickets(tickets) {
  const summary = {
    total: tickets.length,
    byCategory: {},
    byPriority: {}
  };

  for (const ticket of tickets) {
    summary.byCategory[ticket.category] =
      (summary.byCategory[ticket.category] ?? 0) + 1;

    summary.byPriority[ticket.priority] =
      (summary.byPriority[ticket.priority] ?? 0) + 1;
  }

  return summary;
}
برای حقایقی که یک نتیجه صحیح دارند از کدهای معمولی یا SQL استفاده کنید. الگو را برای کارهایی مانند گروه بندی شکایات مشابه معنایی، شناسایی مضامین تکرار شونده و تهیه یک توضیح مختصر ذخیره کنید.
آموزش SitePoint در مورد استفاده از Python و OpenAI API برای تجزیه و تحلیل داده ها، روش های دیگری را نشان می دهد که مدل ها می توانند اطلاعات را از مجموعه داده های ساختاریافته و بدون ساختار استخراج کنند.
ورودی کنترل شده را به مدل ارسال کنید
تابعی ایجاد کنید که تیکت های تبدیل شده و خلاصه قطعی را به یک نقطه پایانی LLM ارسال کند:
async function analyzeTickets(tickets, summary) {
  const response = await fetch(process.env.LLM_API_URL, {
    method: "POST",
    headers: {
      "Content-Type": "application/json",
      "Authorization": `Bearer ${process.env.LLM_API_KEY}`
    },
    body: JSON.stringify({
      instructions: [
        "Analyze only the supplied support-ticket data.",
        "Do not invent totals, categories, or customer details.",
        "Return JSON with keys: themes, urgentIssues, and summary.",
        "Limit themes and urgentIssues to five items each."
      ],
      data: {
        deterministicSummary: summary,
        tickets
      }
    }),
    signal: AbortSignal.timeout(30_000)
  });

  if (!response.ok) {
    throw new Error(
      `LLM request failed with status ${response.status}`
    );
  }

  return response.json();
}
این الگوی مرکزی برای استفاده از است LLM در تجزیه و تحلیل داده ها امن: ارائه یک مجموعه داده محدود، شامل حقایق محاسبه شده توسط کد برنامه، درخواست یک ساختار خروجی تعریف شده، و رد پاسخ هایی که با آن ساختار مطابقت ندارند.
اعتبار پایگاه داده، دستورالعمل های داخلی، یا دسترسی نامحدود به درخواست را در درخواست لحاظ نکنید.
پاسخ را تایید کنید
پاسخ موفقیت آمیز HTTP تضمین نمی کند که داده های برگشتی فرم مورد نیاز را دارند.
function validateAnalysis(value) {
  if (!value || typeof value !== "object") {
    throw new Error("Analysis must be an object.");
  }

  if (!Array.isArray(value.themes)) {
    throw new Error("Analysis is missing a themes array.");
  }

  if (!Array.isArray(value.urgentIssues)) {
    throw new Error("Analysis is missing an urgentIssues array.");
  }

  if (typeof value.summary !== "string") {
    throw new Error("Analysis is missing a text summary.");
  }

  return {
    themes: value.themes.slice(0, 5),
    urgentIssues: value.urgentIssues.slice(0, 5),
    summary: value.summary.slice(0, 2_000)
  };
}
تأیید شماتیک مهم است زیرا خروجی مدل یک ورودی غیرقابل اعتماد است. آن را مستقیماً در جستارهای SQL، قالبهای HTML، دستورات پوسته یا اقدامات تجاری خودکار قرار ندهید.
اگر تجزیه و تحلیل می تواند دسترسی به حساب، بازپرداخت وجه یا مشتریان را تحت تأثیر قرار دهد، قبل از اقدام به بررسی قطعی یا بازبینی انسانی نیاز دارد.
سوابق را به عنوان پردازش شده علامت گذاری کنید
فقط پس از تأیید تأیید پاسخ، بلیتها را بهعنوان تحلیل شده علامتگذاری کنید.
async function markTicketsAsAnalyzed(client, ticketIds) {
  await client.query(
    `
      UPDATE support_tickets
      SET analyzed_at = NOW()
      WHERE id = ANY($1::bigint[])
    `,
    [ticketIds]
  );
}
حالا مراحل را به هم وصل کنید:
async function runPipeline() {
  const rows = await extractTickets(100);

  if (rows.length === 0) {
    console.log("No new tickets to analyze.");
    return;
  }

  const tickets = transformTickets(rows);
  const deterministicSummary = summarizeTickets(tickets);

  const rawAnalysis = await analyzeTickets(
    tickets,
    deterministicSummary
  );

  const analysis = validateAnalysis(rawAnalysis);
  const client = await pool.connect();

  try {
    await client.query("BEGIN");

    await client.query(
      `
        INSERT INTO ticket_analysis
          (ticket_count, result, created_at)
        VALUES ($1, $2::jsonb, NOW())
      `,
      [tickets.length, JSON.stringify(analysis)]
    );

    await markTicketsAsAnalyzed(
      client,
      tickets.map(ticket => ticket.id)
    );

    await client.query("COMMIT");
  } catch (error) {
    await client.query("ROLLBACK");
    throw error;
  } finally {
    client.release();
  }
}
این تراکنش تضمین می کند که رکورد تجزیه و تحلیل و به روز رسانی بلیط یا با هم موفق می شوند یا با هم شکست می خورند.
قبل از اجرای خط لوله، جدول نتیجه را ایجاد کنید:
CREATE TABLE ticket_analysis (
  id BIGSERIAL PRIMARY KEY,
  ticket_count INTEGER NOT NULL,
  result JSONB NOT NULL,
  created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);
در نهایت خط لوله را شروع کرده و استخر را ببندید:
runPipeline()
  .catch(error => {
    console.error(error);
    process.exitCode = 1;
  })
  .finally(async () => {
    await pool.end();
  });
اقدامات احتیاطی در تولید
نسخه ی نمایشی کار فقط شروع است. خط لوله تولید همچنین باید شامل موارد زیر باشد:
- برای پایگاه داده موقت و خطای مدل، سیاست را دوباره امتحان کنید.
- برای جلوگیری از تجزیه و تحلیل تکراری، ناتوانی را کنترل می کند.
- معیارهای اندازه دسته، مدت زمان، استفاده از رمز و خطاها.
- صفی از حروف مرده برای رکوردهایی که مکرراً با شکست مواجه می شوند.
- دستورات نسخه و قوانین تبدیل.
- خط مشی حفظ مدل فوری و پاسخ.
- تست هایی که زمینه های حساس را تایید می کنند هرگز به مدل نمی رسند.
نام مدل، نسخه فوری و نسخه خط لوله را با هر نتیجه تجزیه و تحلیل ذخیره کنید. بدون این ابرداده، بازتولید یک نتیجه یا مطالعه تغییرات در رفتار دشوار می شود.
شما همچنین باید تجزیه و تحلیل را در برابر مجموعه ای از داده های آزمون بررسی شده ارزیابی کنید. اندازهگیری کنید که آیا موضوعات توسط سوابق منبع پشتیبانی میشوند یا خیر و اینکه آیا مسائل فوری از قلم افتاده یا ابداع شدهاند. یک دستور خوب نوشته شده جایگزینی برای ارزیابی نیست.
افکار نهایی
یک خط لوله مستحکم PostgreSQL به LLM، پردازش داده های قطعی را از تفسیر احتمالی جدا می کند. PostgreSQL نیاز به فیلتر کردن رکوردها، اعمال محدودیت ها و محاسبه مقادیر دقیق دارد. کد برنامه باید داده ها را ویرایش و تأیید کند. LLM فقط باید تجزیه و تحلیل زبانی را انجام دهد که برای آن مورد نیاز است.
این جداسازی سیستم را برای آزمایش آسانتر، کارکرد ارزانتر و استقرار ایمنتر میکند. مهمتر از آن، از تبدیل شدن عملکرد تحلیلی مفید به یک مسیر کنترل نشده بین یک پایگاه داده تولید و یک مدل خارجی جلوگیری می کند.